어랏, 아직 사용자는 나 하나인데?
회사에 다니며 취미로 개인 서비스를 만들다 보니, 만드는 것만큼이나 알리는 것도 어렵다는 걸 느꼈다. 비슷한 어려움을 겪는 사람들을 만나 시작한 서비스가 “모여”다. 목표는 누구나 자신을 알릴 수 있게 돕는 것이었다. 서비스·제품을 만든 사람부터 개인 브랜딩을 하는 사람, 소상공인까지 손쉽게 자기 브랜드를 알릴 수 있도록 만들고 싶었다.
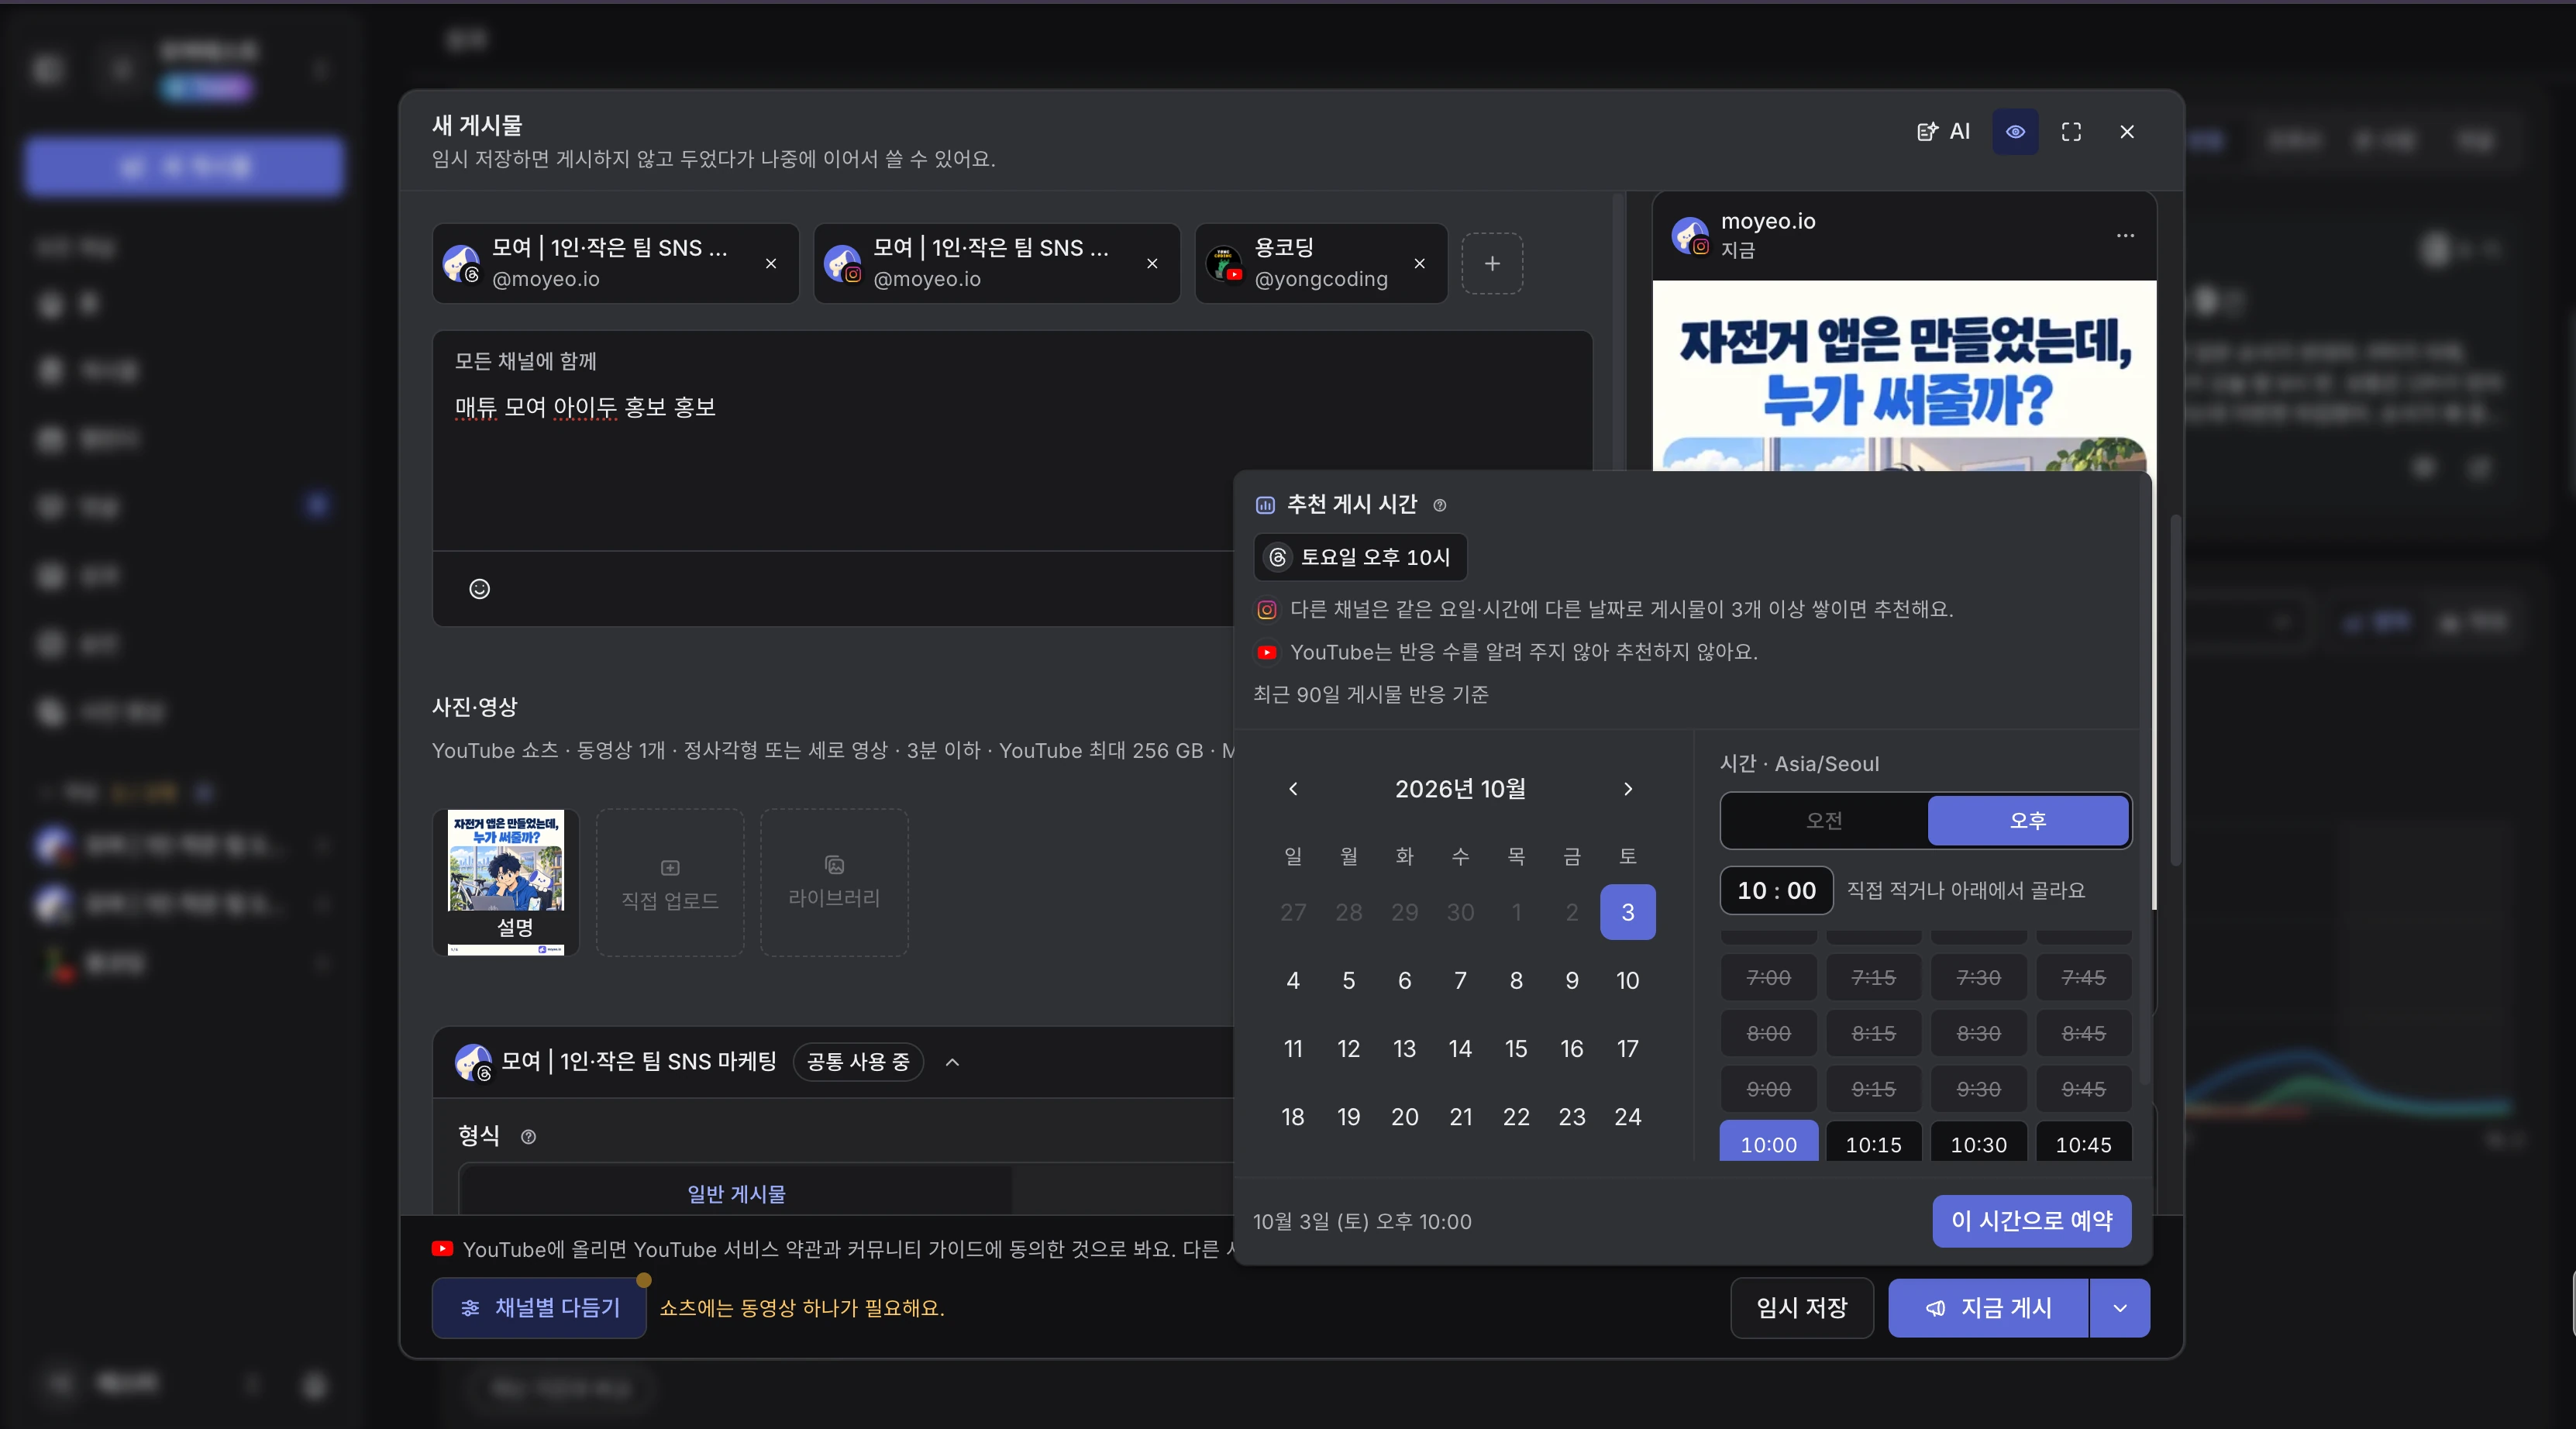
현재 “모여”는 외부 SNS API 심사로 인해 베타 테스터에게만 공개하고 있습니다. 회원가입은 가능하지만, 테스터 등록 전에는 서비스 이용이 제한됩니다. 관심 있으신 분은 베타 신청 폼으로 신청해 주세요. 보내주신 정보를 확인해 테스터로 등록한 뒤 회신드리겠습니다.
니즈를 빠르게 검증하고 약 한 달 동안 서버·클라이언트·인프라를 만들었다. 여러 SNS의 예약 발행과 댓글·성과 관리, AI 작성 지원을 중심으로 구독 결제·환불, 요금제별 이용 한도와 팀원별 접근 권한까지 구현했다. 사용자 흐름을 살펴볼 Analytics와 활성화·유료 전환·매출을 확인할 KPI도 설계했다. 운영자 화면과 쿠폰을 붙이고 각 SNS의 앱 심사까지 거치니, 화면에서 보이는 것보다 손이 가는 일이 훨씬 많았다.
화면 디자인부터 소개 이미지와 문구, 홍보까지 혼자 챙기는 것도 쉽지 않았다. 다른 사람들이 자신을 알리도록 돕는 서비스를 만들면서, 정작 내 서비스를 어떻게 보여주고 알릴지도 계속 고민해야 했다.
혼자 만드는 서비스라 운영 비용도 아끼고 싶었다. API와 백그라운드 워커를 EC2 한 대에 올리고, 작은 PostgreSQL DB로 시작했다. 당장은 서버 사양을 올릴 생각이 없었다.
프론트엔드 구현과 서비스 기획에서 고민했던 이야기도 다음 글로 풀어볼 예정이다. 많관부 🙂
그런데 커넥션 풀 고갈 오류가 났다. 아직 정식 출시도 안 했고 사용자는 나 하나인데, 벌써 서버를 키워야 하나? 비용을 아끼려던 나에게는 조금 충격이었다. 사양부터 올리기 전에 어디서 막혔는지 로그를 살펴봤다.
DB의 CPU 사용률은 낮았는데 워커는 연결을 얻으려고 5초씩 기다리고 있었다. 코드를 따라가니 한 작업이 여러 연결을 동시에 빌리거나, 연결을 잡은 채 락을 기다리는 부분이 보였다. 이 글에서는 그 과정에서 놓쳤던 부분과, 작은 인프라 안에서 일을 나눠 처리하도록 바꾼 경험을 정리해보려 한다.
CPU 사용률은 낮은데, 왜 느릴까?
작업이 느려지면 CPU 사용률부터 보기 쉽다. 높으면 처리할 일이 많은 것 같고, 낮으면 서버에 여유가 있다고 생각하기 쉽다. 하지만 사용자가 기다리는 시간 내내 CPU를 쓰는 것은 아니다.
예를 들어 “모여”에서 댓글을 가져온다는 것은 연결한 SNS 계정의 게시물을 찾고, 그 게시물에 달린 댓글을 해당 SNS의 API로 읽어와 저장하는 일이다. 댓글이 여러 페이지에 나뉘어 있으면 다음 페이지도 요청해야 한다. 받은 데이터를 해석하고 정리할 때는 계산을 하지만, SNS에서 응답이 돌아오기 전까지는 기다린다.
저장할 차례가 돼도 바로 진행하지 못할 수 있다. DB 연결을 빌릴 차례를 기다리거나, 다른 작업이 같은 데이터를 처리하고 있어서 락이 풀리기를 기다리기도 한다. 락은 같은 대상을 동시에 바꾸지 못하도록 처리 순서를 정하는 장치다.
이런 대기는 처리 시간을 늘린다. 그렇다고 기다린 시간만큼 CPU 사용률이 올라가지는 않는다. 작업이 5초 걸렸어도 실제 계산은 아주 짧았을 수 있다. CPU 사용률만으로는 작업이 어디서 얼마나 기다렸는지 알 수 없다.
아래 그림은 세 가지 상황을 같은 축으로 비교한다. 파란 선은 CPU 사용률, 보라색 선은 작업 하나를 마치는 데 걸리는 시간이다. 세 그래프는 흐름을 이해하기 위한 개념 예시다.
첫 번째 상황에서는 작업이 짧게 끝난다. CPU 사용률이 조금 오르내려도 작업은 계속 짧은 시간 안에 끝난다. 계산도 길지 않고, 다음 단계로 넘어가는 데 오래 기다리지 않는 상태다.
두 번째 상황은 CPU 사용률이 낮은데 처리 시간이 늘어나는 경우다. 이때는 무엇을 기다리는지 살펴봐야 한다. DB 응답이 느릴 수도 있고, 풀의 빈 연결을 기다릴 수도 있고, 외부 서비스가 응답하지 않을 수도 있다. CPU 사양을 올려도 이런 대기는 그대로일 수 있다.
세 번째 상황에서는 CPU 사용률과 처리 시간이 함께 오른다. 처리해야 할 일이 늘었거나 계산이 무거워졌을 가능성을 확인한다. 요청 수는 평소와 비슷한데 CPU 사용률만 올랐다면 오래 걸리는 계산이나 반복문을 먼저 확인한다. 요청도 함께 늘었다면 현재 서버가 처리할 수 있는 양을 넘어섰는지 살펴본다.
실제 장애에서 RDS의 CPU 사용률은 낮았지만 워커는 연결을 오래 기다렸다. 쿼리가 느린 것인지, 쿼리를 실행하기도 전에 연결을 기다리는 것인지 구분해야 했다.
연결 여덟 개를 함께 쓴다는 것
DB를 사용하려면 연결이 필요하다. 작업이 생길 때마다 새 연결을 만들었다가 닫을 수도 있지만, 연결을 만드는 데도 시간이 들고 DB가 감당할 수 있는 연결 수에도 한계가 있다. 그래서 애플리케이션은 연결 몇 개를 재사용한다. 이 연결들을 관리하는 것이 커넥션 풀이다.
풀을 처음부터 어려운 장치로 생각할 필요는 없다. 필요한 순간에 연결을 빌리고, 일을 마치면 돌려주는 구조다. 풀은 동시에 빌려줄 수 있는 연결 수를 제한한다. 최대 여덟 개라면 아홉 번째 작업은 앞선 작업이 연결 하나를 돌려줄 때까지 기다린다.
아래 그림에서는 연결 여덟 개에 먼저 작업 여덟 개가 들어온다. 각 작업은 연결을 1.5초 사용한다. 0.5초 뒤에 작업 네 개가 더 도착한다. 새로 온 점들이 어디에 머무는지 보자.
추가된 네 개는 바로 DB로 가지 못한다. 연결 여덟 개가 모두 사용 중이기 때문이다. 풀 바깥에서 기다리다가 먼저 시작한 작업들이 연결을 돌려주면 빈자리로 들어간다. 그래프의 대기 수가 줄어드는 순간과 점이 연결 칸에 들어가는 순간은 같은 사건이다.
새로 도착한 작업이 경험하는 시간은 자신의 DB 처리 시간만이 아니다. 연결을 빌릴 차례를 기다린 시간도 포함된다. 예시에서는 1초를 기다린 뒤 1.5초 동안 처리하므로, 도착부터 완료까지 2.5초가 걸린다. DB가 실행한 부분만 재면 1.5초지만 작업 전체는 더 오래 걸린다.
DB가 보는 연결과, 애플리케이션이 기다리는 요청
이 대기 줄은 아직 DB 연결을 얻지 못한 요청이다. PostgreSQL이 보는 세션 수에 그대로 나타나지 않는다. DB 대시보드에서 연결 수가 적어 보여도, 애플리케이션 내부에는 연결을 기다리는 호출이 쌓여 있을 수 있다.
DB가 연결을 더 받아줄 수 있다는 것과 내 풀에 지금 빈자리가 있다는 것은 다르다. DB의 전체 상한이 넉넉하더라도, 프로세스의 풀을 여덟 개로 정했다면 그 프로세스는 여덟 개 안에서 돌려써야 한다. 다른 프로세스의 풀에 빈 연결이 있다고 자동으로 빌려오는 것도 아니다.
API와 워커가 같은 DB를 사용해도 각자 만든 풀은 별개다. API의 풀이 비어 있는데 워커의 풀이 꽉 찰 수 있다. 전체 연결 수를 하나로 합친 그래프만 보면 어느 프로세스가 자기 상한에 도달했는지 놓치기 쉽다.
풀의 최대치도 실제로 열려 있는 연결 수와 구분해야 한다. 최대 여덟 개라는 설정은 필요할 때 여덟 개까지 만들 수 있다는 뜻이지, 항상 여덟 개를 열어둔다는 뜻은 아니다. 유휴 연결을 정리하는 설정에 따라서도 관측값은 달라진다. node-postgres의 풀 문서는 연결을 빌리고 돌려주는 기본 동작을 설명한다.
연결은 언제 돌아오는가
쿼리 하나를 마치고 연결을 돌려주기도 하고, 여러 쿼리를 한 트랜잭션으로 묶어 마지막까지 사용하기도 한다. 트랜잭션은 여러 DB 변경을 함께 확정하거나 함께 취소하는 단위다. 그동안 같은 연결을 사용하므로 끝날 때까지 다른 작업에 빌려줄 수 없다.
중요한 것은 연결을 빌린 뒤 무엇을 하는가다. DB 조회에 10ms를 쓰고 외부 API를 3초 기다리는 동안에도 연결을 잡고 있다면, 다른 작업은 그 연결을 3초 이상 사용할 수 없다. DB의 CPU 사용률은 낮아도 연결은 계속 사용 중인 셈이다.
그래서 풀 고갈을 만났을 때는 두 가지를 확인한다. 동시에 필요한 연결이 몇 개인지, 빌린 연결을 얼마나 오래 쓰는지다. 들어오는 작업 수가 같아도 연결을 오래 잡고 있으면 기다리는 호출이 늘어난다.
사용자는 한 명이어도, 일은 계속 생긴다
서버 작업 수를 사용자 수로 짐작하면 이 계산을 놓치기 쉽다. 사용자 한 명이 버튼을 한 번 눌렀으니 작업도 하나일 것 같지만, 실제 서비스의 일은 그보다 길게 이어진다.
개인 블로그에 예약 글을 올리는 서비스라면 조금 더 단순할 수 있다. 내가 관리하는 DB에 글을 저장하고, 정해진 시각에 공개 상태로 바꾸면 된다. “모여”에는 외부 SNS API라는 요소가 하나 더 있었다. 내가 준비를 끝냈다고 연동한 SNS도 바로 처리해주는 것은 아니었다.
게시물 하나를 예약하면 발행 시각을 확인하고, 파일을 준비하고, 각 SNS에 맞는 요청을 보내고, 결과를 저장한다. SNS마다 업로드 순서와 요청·응답 형식도 다르다. 중간에 끊겼다면 이미 발행됐는지 다시 확인해야 한다. 발행 뒤에는 새 댓글과 성과를 가져오는 일도 이어진다.
연결한 SNS 계정으로 계속 발행하고 데이터를 읽으려면 인증 정보도 유효해야 한다. API 접근 권한을 확인하는 토큰을 SNS별 방식에 맞춰 갱신하고, 다시 로그인이 필요한 경우에는 계정 재연결을 안내한다. 실패한 작업을 다시 처리하고 오래된 파일과 작업 기록을 정리하는 일도 있다.
아래 그림은 예약 하나 주변에서 계속 생기는 일을 묶어 보여준다.
모든 일을 사용자가 화면을 보고 있을 때만 하면 예약 서비스가 될 수 없다. 브라우저를 닫아도 발행은 진행돼야 하고, 다음 날 들어온 댓글도 발견해야 한다. 이런 일들은 HTTP 요청을 받는 API와 분리해서 백그라운드 워커가 맡는다.
여기서 워커는 뒤에서 작업을 처리하는 프로세스를 뜻한다. 작업 하나마다 운영체제 스레드 하나를 만든다는 의미는 아니다. 워커 프로세스 하나도 여러 비동기 작업을 함께 다룰 수 있고, 그 작업들이 같은 DB 풀을 사용한다.
자주 확인한다고 더 잘 가져오는 것은 아니다
댓글이 빨리 보이면 좋겠다고 매초 SNS를 조회하면 어떨까. 서버를 늘리기 전에 외부 API 한도부터 소진할 수 있다. SNS마다 일정 시간에 보낼 수 있는 요청 수나 하루에 쓸 수 있는 사용량, 즉 quota가 다르다. YouTube는 작업마다 사용 비용을 계산하고, 할당량을 넘으면 데이터를 주는 대신 quotaExceeded 오류를 반환한다. 사용량 계산, 오류 문서
Meta API의 일부 응답에는 X-App-Usage 같은 사용량 헤더가 온다. Meta의 공식 Instagram API 예시에서도 확인할 수 있다. “모여”는 이런 사용량 정보와 오류의 재시도 정보를 읽는다. 한도가 부족하면 같은 요청을 즉시 반복하지 않고, 다시 수집할 수 있는 시각으로 작업을 미룬다.
사용자에게는 새 댓글이 안 보이는 답답한 상황이지만, 그때 요청을 더 보내는 것이 해결책은 아니다. 너무 자주 확인하면 오히려 다음 데이터를 가져올 기회를 잃는다. 갱신 주기는 원하는 실시간성뿐 아니라 각 SNS의 API 한도와 남은 사용량에 맞춰 정해야 했다. 제한이 풀리는 시각도 SNS와 오류에 따라 다르므로 모든 제한을 몇 분짜리 대기로 처리할 수는 없다.
외부 요청의 간격을 정했어도, 내부 작업이 동시에 몰리는 문제는 남았다. 하루에 처리할 일이 적어도 매분 실행하는 검사들이 같은 초에 도착하면 순간적으로 몰린다. “하루 몇 건인가”와 “같은 순간 몇 건인가”는 다른 질문이었다.
“모여”에서는 당시 정기 작업 29개가 같은 순간에 등록됐다. 실행 자리는 전체 작업을 합쳐 네 개였고, 정기 작업 15개가 약 9.5초 기다렸다. 사용자가 갑자기 늘어난 사건이 아니라, 주기적으로 해야 할 일이 같은 시각에 몰린 것이었다.
사용자 수가 늘면 작업도 늘겠지만 그 비율은 기능에 따라 다르다. 같은 한 명이어도 연결한 채널 수, 예약 게시물 수, 수집 주기에 따라 뒤에서 하는 일이 달라진다. 작은 서비스를 계획할 때도 먼저 세어야 할 것은 그 순간 실행할 일이다.
한 명의 SNS 기록도 작은 데이터는 아니다
수집할 데이터는 서비스에 가입한 뒤 올린 글만이 아니다. 이미 운영하던 SNS 계정을 연결하면 기존 게시물과 댓글, 성과 정보도 가져와야 한다. “모여”의 요금제 설정에서 댓글·성과의 제공 기간은 무료 30일, 유료 730일이다. 최근 한 달을 보는 사람과 약 2년을 보는 사람의 처리량은 같을 수 없다.
평소 글을 자주 올리고 댓글도 많이 달리는 계정이라면, 사용자 한 명이 연결한 채널에도 처리할 기록이 상당히 많다. SNS 응답을 기다리는 시간뿐 아니라 데이터를 해석하고 정리하는 CPU 시간, 응답과 객체를 담아두는 메모리, 결과를 저장할 DB 연결도 필요하다. 한 명이라는 숫자만으로 가벼운 작업이라고 볼 수 없었다.
물론 요금제의 제공 기간이 모든 SNS에서 그 기간의 데이터를 한 번에 가져올 수 있다는 뜻은 아니다. SNS마다 조회 가능한 과거 범위와 API 한도가 다르다. 성과 데이터는 연결 이후부터 쌓아야 하는 항목도 있다. 서비스가 보여줄 기간과 실제로 수집할 수 있는 범위를 함께 보고 일을 정해야 한다.
한꺼번에 읽기보다, 조금씩 이어 읽기
2년치 데이터를 한 번의 작업에서 모두 읽고 마지막에 저장하면 어떻게 될까. 중간 결과를 오래 메모리에 들고 있어야 하고, 끝에서 실패하면 어디까지 했는지도 알기 어렵다. 긴 수집 하나가 실행 자리를 오래 차지하는 문제도 생긴다.
그래서 “모여”의 최초 게시물 수집은 페이지 단위로 진행한다. 가져온 페이지를 저장하면서 다음에 읽을 위치도 남긴다. 이 위치가 커서이고, 어디까지 처리했는지 저장한 기록이 체크포인트다. 한 번에 처리할 페이지 수를 채우면 작업을 마치고, 후속 작업이 저장한 위치부터 이어간다.
페이지 데이터와 진행 위치, 후속 작업은 같은 트랜잭션으로 저장한다. 데이터를 저장하지 못했는데 진행 위치만 앞서가면 빠뜨리는 페이지가 생길 수 있기 때문이다. 저장이 함께 성공해야 다음 작업도 이어서 시작할 수 있다. 이 원리가 뒤에서 설명할 작업 큐 선택과 연결된다.
댓글 수집도 다음 페이지의 위치를 남기며 진행한다. 성과의 과거 구간을 채우는 작업은 한 실행에서 쓸 API 요청 예산과 해당 SNS가 허용하는 조회 기간을 보고 범위를 나눈다. 모든 데이터를 똑같은 크기로 자르는 대신, 수집 대상에 맞춰 한 번에 할 일을 제한하는 것이다.
이런 처리를 배치라고 부를 수 있다. 배치는 여러 데이터를 일정한 단위로 묶어 처리하는 방식이다. Spring Batch도 청크 단위로 읽고 처리한 결과를 트랜잭션 안에서 저장하는 구조를 제공한다.
NestJS에서도 같은 원리로 구현할 수 있다. “모여”에서는 별도 배치 프레임워크 대신 PostgreSQL 기반 작업 큐인 pg-boss와 수집 코드를 조합했다.
pg-boss는 실행할 작업을 보관하고 워커에 전달한다. 어떤 SNS의 어느 페이지를 읽을지, 한 번에 얼마나 할지, 진행 위치를 어떻게 저장할지는 서비스 코드가 맡는다. 큐를 붙였다고 자동으로 큰 수집이 작게 나뉘지는 않는다. 작업을 나누는 것과, 나눈 작업을 몇 개씩 실행하는 것은 모두 정해야 했다.
작업 네 개가 연결 네 개는 아니었다
동시에 실행할 작업을 제한했으니 연결도 제한됐을 것이라고 생각할 수 있다. 작업 네 개까지만 허용하고 풀에는 여덟 개가 있으면 여유가 있어 보인다. 이 계산은 작업 하나가 연결 하나를 요구할 때만 맞는다.
작업 안에서 DB 호출 여러 개를 동시에 시작하면 이야기가 달라진다. 작업 하나가 연결 네 개를 빌릴 수 있다. 그런 작업이 네 개라면 필요한 연결은 열여섯 개다. 실행 중인 작업은 네 개인데 풀에는 열여섯 호출이 들어오는 것이다.
아래 그림의 작업 A·B·C·D는 각자 DB 호출 네 개를 한다. 왼쪽은 네 호출을 한꺼번에 시작하고, 오른쪽은 두 개씩 시작한다. 풀 크기는 양쪽 모두 여덟 개로 같다. 주황색 점은 이미 시작했지만 연결을 못 얻은 호출, 회색 점은 아직 시작하지 않은 다음 차례다.
왼쪽에서는 연결 여덟 개를 다 쓰고 나머지 여덟 요청이 풀에서 기다린다. 오른쪽에서는 작업 네 개가 두 연결씩 빌리므로 동시에 필요한 연결은 여덟 개다. 나머지는 각 작업 안에서 순서를 기다린다.
총 해야 할 일이 줄어든 것은 아니다. 그림의 양쪽에는 모두 열여섯 호출이 있다. 바뀐 것은 같은 순간에 공유 풀로 보내는 호출 수다. 일을 모두 시작한 뒤 풀이 알아서 조절하게 하는 것과, 시작할 양을 작업 쪽에서 정하는 것은 다르다.
오른쪽도 처음에는 여덟 연결을 모두 쓴다. 다른 작업을 위한 자리까지 남기려면, 작업별 제한과 함께 전체 실행 작업 수도 조절해야 한다.
“모여”에서는 한 번에 여러 대상을 훑는 작업이 트랜잭션 네 개를 병렬로 열었고, 미디어 복구 작업은 일곱 개를 열었다. 작업 네 개가 동시에 실행되면 연결 16~28개를 요구할 수 있었는데, 워커 업무 풀은 여덟 개였다.
바깥쪽 제한기는 작업을 하나로 셌지만 작업 안에서는 여러 연결을 빌리고 있었다. 이 차이가 당시 설계에서 놓친 부분이었다. 작업의 개수만 제한해서는 DB 호출의 개수까지 제한되지 않는다.
작업을 작게 나누는 것만으로 해결되는 문제도 아니다. 하나였던 작업을 일곱 개로 쪼갠 뒤 전부 동시에 실행하면 동시에 필요한 연결 수는 그대로일 수 있다. 작업을 나눌 때도 어떤 작업들이 같은 풀을 쓰는지 확인해야 한다.
이후에는 작업당 동시에 실행하는 트랜잭션을 최대 두 개로 제한했다. 작업 몇 개를 실행할지 정하는 바깥쪽 제한과, 작업 하나 안에서 DB 호출 몇 개를 겹칠지 정하는 안쪽 제한을 함께 둔 것이다.
Promise.all이면 무조건 빨라질까?
독립적인 일은 병렬로 실행하는 편이 빨라질 때가 많다. 서로 다른 외부 API의 응답을 기다리는 시간을 겹칠 수 있고, DB 연결이 충분하면 두 조회를 함께 시작할 수도 있다. 문제는 독립적인 함수가 반드시 독립적인 자원을 사용하는 것은 아니라는 점이다.
두 함수가 서로의 결과를 필요로 하지 않아도 같은 DB 풀을 사용할 수 있다. 각각 연결 하나를 빌리면 함께 실행하는 동안 두 자리를 차지한다. 코드의 의존성이 없다는 것과 자원을 두 배 써도 괜찮다는 것은 별개다.
Promise 콜백도 실행 차례를 기다린다
JavaScript는 외부 응답을 기다리는 동안 다른 요청을 처리할 수 있다. 네트워크 작업이 끝나면 그 결과를 처리할 콜백이 실행 차례를 기다린다. 다만 같은 JavaScript 실행 스레드에서는 두 코드를 동시에 실행하지 않는다. 긴 동기 계산이 시작되면 다른 콜백도 그 계산이 끝나기를 기다려야 한다.
순서를 보기 위해 브라우저에서 실행할 수 있는 짧은 예시를 보자.
setTimeout(() => console.log("타이머"), 0);
Promise.resolve().then(() => console.log("Promise"));
console.log("동기 코드");ts위에서부터 적었지만 출력은 동기 코드 → Promise → 타이머 순서다. 지금 실행 중인 함수는 호출 스택에 쌓인다. setTimeout의 0은 즉시 실행하라는 뜻이 아니다. 타이머가 준비되면 콜백이 태스크 큐에서 차례를 기다린다. 이미 완료된 Promise의 .then 콜백은 별도의 마이크로태스크 큐에 들어간다.
현재 동기 코드가 끝나 호출 스택이 비면 마이크로태스크부터 처리한다. 그 과정에서 추가된 마이크로태스크까지 비운 뒤 다음 태스크를 실행하므로, 이 예시에서는 Promise 콜백이 타이머보다 먼저 나온다. MDN의 마이크로태스크 설명도 이 순서를 다룬다.
아래 그림은 같은 코드를 비교한다. 왼쪽은 동기 코드가 짧게 끝난다. 오른쪽은 마지막 출력 전에 긴 동기 계산을 넣었다. 두 큐에 콜백이 준비돼 있어도 호출 스택에서 계산이 끝나지 않으면 실행하지 못한다.
Promise를 만들었다고 계산이 다른 스레드로 옮겨지는 것도 아니다. new Promise에 전달한 함수 자체는 즉시 실행된다. 오래 걸리는 반복문을 그 안에 넣어도 현재 실행 스레드를 계속 사용한다. “모여” 서버는 Bun으로 실행한다. 세부 실행 순서는 런타임마다 다르지만, 서버에서도 긴 동기 JavaScript 계산은 같은 스레드에서 실행할 다른 콜백을 늦춘다.
Promise.all은 전달한 Promise들이 모두 성공할 때까지 기다리고, 하나가 실패하면 실패를 알린다. 실패했다고 이미 시작한 호출이 자동으로 취소되는 것도 아니다. 동시에 시작할 호출 수는 Promise.all 밖에서 제한해야 한다. MDN의 Promise.all 문서에서도 이 동작을 확인할 수 있다.
다음 예시에서 runShortTransaction은 항목 하나를 짧은 DB 트랜잭션 하나로 처리하는 함수다. map이 각 함수를 호출하면서 작업을 시작하고, Promise.all은 그 결과를 모아 기다린다. 항목이 여덟 개라면 풀에 빈 연결이 있는지와 관계없이 여덟 호출을 시작한다.
await Promise.all(items.map(runShortTransaction));ts작업은 빨라졌는데, 화면은 더 느려졌다
풀에 연결 네 개가 있고, 같은 풀에서 DB 작업 여덟 개와 화면 조회 하나를 처리한다고 가정해보자. DB 작업은 각각 250ms, 화면 조회는 50ms가 걸린다. DB 작업을 시작하고 50ms 뒤에 화면 조회가 들어온다.
세 가지 방식을 비교한다. 하나씩 실행하기, 두 개씩 실행하기, 여덟 개를 한꺼번에 시작하기다. 아래 그림에서 파란 막대는 DB 작업, 초록 막대는 화면 조회, 주황 막대는 화면 조회가 연결을 기다리는 시간이다.
하나씩 실행하면 작업 묶음은 2초에 끝난다. 연결 하나만 쓰고 있으므로 중간에 들어온 화면 조회는 다른 연결에서 바로 시작한다. 도착부터 완료까지 걸리는 시간은 50ms다.
두 개씩 실행하면 묶음은 1초에 끝난다. 동시에 두 연결을 사용하므로 화면 조회를 위한 자리가 남는다. 이 경우에도 조회는 바로 시작해 50ms에 끝난다.
여덟 개를 한꺼번에 시작하면 첫 네 개가 연결을 쓰고 다음 네 개가 풀에 줄을 선다. 뒤늦게 들어온 화면 조회는 그 뒤에 선다. 먼저 들어온 여덟 개가 모두 끝난 500ms 시점에야 연결을 얻고, 50ms 동안 실행한다. 조회가 도착한 시점부터는 500ms가 걸린 셈이다.
작업 묶음은 가장 빨리 끝났는데, 화면 조회는 열 배 오래 걸렸다. 백그라운드 작업이 연결을 먼저 차지한 만큼, 뒤에 들어온 화면 조회가 기다려야 했다.
실제 조회에서는 얼마나 달라졌을까?
“모여”의 성과 조회도 두 조회를 순서대로 실행할 때와 함께 실행할 때를 비교했다. 격리된 DB에서 초당 5·10·20회 읽기를 보내고, API 풀 상한을 네 개로 두었다. 병렬 조회에서 풀 상한을 여섯 개로 늘린 조건도 비교했다.
측정한 것은 성과 데이터를 읽는 코드 구간, 즉 reader 구간의 실행 시간이다. 인증이나 응답 전송까지 포함한 전체 HTTP 응답 시간은 아니다.
초당 20회 읽는 조건에서 p95는 순차와 병렬 모두 약 23.3ms였다. p95는 표본의 95%가 그 시간 안에 끝났다는 지표다. 반면 관측된 연결은 순차 한 개, 병렬 두 개였다.
이 실험에서는 사용하는 연결 수가 늘었는데 조회 시간은 거의 줄지 않았다. 그래서 해당 조회는 순차 실행을 유지했다. 빠르게 끝나는 조회라면 연결을 두 개씩 쓸 만큼의 이득이 있는지 확인할 필요가 있었다.
제한된 병렬 실행도 Promise.all을 쓴다
이 경험 뒤에 Promise.all을 전부 없앤 것은 아니다. 현재 워커에서는 mapWithBoundedConcurrency라는 공통 함수로 실행 수를 제한한다. 내부에서는 정해진 크기로 항목을 나누고, 각 묶음을 Promise.all로 기다린다. 앞의 예시를 같은 원리로 바꾸면 다음과 같다.
await Promise.all(items.map(runShortTransaction));
const maximumConcurrency = 2;
for (let offset = 0; offset < items.length; offset += maximumConcurrency) {
  const batch = items.slice(offset, offset + maximumConcurrency);
  await Promise.all(batch.map(runShortTransaction));
}ts두 개가 끝나면 다음 두 개를 시작한다. 각 항목이 트랜잭션 하나를 실행한다는 앞의 가정에서는, 이 작업이 동시에 시작하는 DB 호출도 최대 두 개다. 실제 공통 함수에는 입력 검증과 결과 수집도 있다. 위 코드는 실행 순서만 보여주도록 줄였다.
Promise.all을 없애는 것보다, 한 번에 시작할 호출 수를 정하는 것이 중요했다.
이후에는 병렬로 실행하기 전에 같은 풀을 쓰는지, 연결을 몇 개 쓰는지, 실제로 얼마나 빨라지는지부터 확인한다. 내 작업이 빨리 끝나더라도 다른 요청을 오래 기다리게 한다면 전체 서비스에는 손해일 수 있다.
락을 기다리느라 연결까지 잡고 있었다
동시에 시작하는 DB 호출을 줄여도 대기가 사라지지는 않는다. 같은 채널을 두 작업이 동시에 처리하면 안 되는 경우가 있기 때문이다. 한 작업이 상태를 읽고 외부 데이터를 수집하는 동안 다른 작업이 같은 채널의 상태를 바꾸면, 앞서 저장한 진행 위치를 덮어쓸 수 있다.
이런 겹침을 막는 장치가 락이다. 먼저 들어간 작업이 처리 권한을 얻고, 다른 작업은 권한이 풀릴 때까지 기다리거나 나중에 다시 시도한다. 문제는 기다리는 방식이다. 기다리는 동안 어떤 자원을 잡고 있는지에 따라 다른 작업의 자리도 달라진다.
연결을 빌린 뒤 락을 얻을 때까지 기다린다고 생각해보자. 채널을 처리하는 작업 A가 이미 실행 중이다. 같은 채널을 처리하려는 B·C·D는 연결을 하나씩 빌리고, A가 락을 풀기를 기다린다. 일을 진행하는 것은 A 하나인데 연결은 네 개가 사용 중이다.
왼쪽에서는 기다리는 세 작업도 연결을 차지한다. CPU를 많이 쓰지는 않지만 다른 작업에 연결을 빌려줄 수 없다. 이때 CPU만 보면 여유로워 보이고, 풀에서 보면 자리가 없다. 계산을 하지 않는 동안에도 연결은 계속 차지하고 있는 것이다.
오른쪽에서는 지금 락을 얻을 수 있는지 짧게 확인한다. 다른 작업이 락을 잡고 있다면 연결을 돌려주고, 잠시 뒤에 다시 시도하도록 작업을 미룬다. 기다리는 동안에는 다른 채널의 작업이 연결을 사용할 수 있다. 같은 채널을 중복 처리하지 않으면서도 공유 풀을 오래 붙잡지 않는 방식이다.
미룬 것은 실패한 것이 아니다
이미 같은 채널을 정상적으로 처리하는 작업이 있어서 기다리는 경우는 외부 API 실패와 다르다. 아직 실제 처리를 시작하지 못했는데 실패 횟수를 올리면, 차례를 기다리기만 한 작업이 재시도 한도를 소모할 수 있다.
그래서 작업을 다음 시각으로 옮기는 것과 실패 재시도를 구분한다. 미룬 작업은 큐에 남겨두고 다시 실행할 시각을 지정한다. 실제 요청을 보냈다가 실패한 경우에는 오류에 맞춰 재시도 횟수와 간격을 정한다.
다시 시도할 때도 모두 같은 순간에 몰리면 같은 경쟁이 반복된다. “모여”에서는 해당 워커 경로를 try-lock으로 바꾸고, 얻지 못하면 2~5초 사이에 시각을 분산해 다시 시도하도록 했다. 이런 작은 시간 차이를 지터라고 한다. 작업들이 다시 한꺼번에 몰리지 않도록 재시도 시점을 조금씩 다르게 잡는 것이다.
연결을 잡은 채 외부 응답을 기다리지 않는다
락뿐 아니라 외부 API와 파일 전송도 같은 관점에서 봐야 한다. 예약 상태를 읽고 SNS에 발행한 뒤 결과를 저장한다면, 세 단계를 하나의 트랜잭션으로 감싸고 싶어진다. 전부 성공하거나 전부 취소되면 안전할 것 같기 때문이다.
하지만 DB에서 상태를 확인하는 데 10ms, SNS 응답을 기다리는 데 3초, 결과 저장에 10ms가 걸린다고 해보자. DB가 실제로 일하는 시간은 20ms인데 연결은 3초 넘게 빌려야 한다. 그 트랜잭션에서 행을 수정하거나 FOR UPDATE로 잠갔다면, 같은 행을 바꾸려는 다른 작업도 트랜잭션이 끝날 때까지 기다린다. await로 JavaScript 실행을 양보해도 DB 연결과 이미 얻은 락까지 돌려주는 것은 아니다.
아래 그림은 같은 외부 요청을 트랜잭션 안에 두는 경우와 밖으로 빼는 경우다. 전체 작업 시간은 비슷해도, DB 연결을 빌리는 구간은 달라진다.
안전해 보였던 묶음에도 문제가 있다. SNS 발행은 성공했는데 마지막 DB 저장이 실패하면 어떨까. DB는 롤백할 수 있지만 이미 SNS에 올라간 글은 저절로 지워지지 않는다. DB 트랜잭션은 외부 HTTP 요청까지 함께 롤백해주지 않는다. 느린 외부 응답을 기다리느라 연결과 락을 오래 잡고도, 기대한 원자성은 얻지 못하는 셈이다.
그래서 “모여”의 성과 수집은 먼저 짧은 트랜잭션에서 이번 실행의 처리 권한을 확보하고, 트랜잭션을 끝낸 뒤 SNS API를 호출한다. 결과가 돌아오면 새 트랜잭션에서 실행 식별자와 상태를 확인하고 저장한다. 이전 실행이 늦게 돌아와도 새 실행의 결과를 덮어쓰지 않도록 한다. 이미지 변환·업로드도 같은 식으로 DB 처리 구간과 외부 작업을 나눈다.
단순히 HTTP 호출을 트랜잭션 밖으로 옮기는 것만으로 끝나지는 않는다. 외부 발행 중에 사용자가 예약을 취소할 수 있다면, 돌아온 결과를 무조건 예약 상태에 덮어쓰면 안 된다. 어떤 실행의 결과인지, 아직 그 결과를 받아들일 상태인지 다시 확인해야 한다. 외부 요청이 성공했는지 알 수 없는 채 끊겼다면, 재시도 전에 이미 처리됐는지도 확인해야 한다.
오래 기다리는 것과 데드락은 다르다
HTTP 요청을 트랜잭션 안에서 보낸다고 곧바로 데드락이 생기는 것은 아니다. 다른 작업이 하나의 락이 풀리기를 기다리는 것은 대기다. 데드락은 서로가 가진 락을 기다려 어느 쪽도 끝낼 수 없는 상태다.
작업 A가 부모 행을 잠그고 자식 행을 바꾸려는데, 작업 B가 자식 행을 잠근 채 부모 행을 바꾸려 한다고 해보자. A는 B를 기다리고 B는 A를 기다린다. 누군가 먼저 끝나야 락이 풀리지만, 둘 다 끝날 수 없다.
“모여”에도 이와 같은 잠금 순서 문제가 있었다. 같은 요청의 중복 실행을 막기 위해 남긴 기록을 정리할 때였다. 만료 기록 삭제는 부모 행을 먼저 잠그고 연결된 자식 행을 지웠다. 별도의 응답 데이터 정리 작업은 자식 행을 먼저 잠근 뒤 부모 행을 수정했다. 두 경로가 겹치면 서로의 락을 기다릴 수 있었다.
응답 정리도 부모 행부터 잠그도록 바꿔 두 경로의 잠금 순서를 부모 → 자식으로 맞췄다. 함께 실행해도 잠금 순서가 뒤집히지 않는지는 통합 테스트로 확인했다. PostgreSQL은 데드락을 발견하면 트랜잭션 하나를 중단시키지만, 매번 중단과 재시도로 해결하는 것보다 같은 순서로 잠그는 편이 낫다. 공식 잠금 문서에서도 이 방법을 설명한다.
트랜잭션을 짧게 유지하면 락을 오래 붙잡는 시간을 줄일 수 있다. 여러 대상을 잠근다면 순서도 맞춰야 한다. 외부 호출을 밖으로 빼는 것과 잠금 순서를 통일하는 것은 각각 다른 원인을 해결하는 일이다.
긴 일과 짧은 일을 같은 줄에 세우면
DB 연결을 얻기 전에도 다른 줄이 있다. 워커가 한 번에 실행할 수 있는 작업 수다. 외부 요청 네 개가 실행 자리를 모두 쓰고 있으면, 짧은 정기 검사도 그 뒤에서 기다릴 수 있다. 풀에는 연결이 남아 있어도 실행 차례가 없으면 시작하지 못한다.
아래 그림은 실행 자리 네 개를 똑같이 두고 비교한다. 왼쪽은 모든 작업이 같은 자리를 사용한다. 오른쪽은 외부 요청에 세 자리, 정기 검사에 한 자리를 남긴다. 외부 작업은 각각 3초, 정기 검사는 0.25초라는 설명용 가정이다.
왼쪽의 정기 검사는 0.5초에 도착하지만 3초가 될 때까지 시작하지 못한다. 자신의 처리는 0.25초밖에 안 되는데, 앞의 긴 작업 때문에 2.5초를 기다린다. 오른쪽에서는 검사 자리가 따로 있으므로 바로 시작한다.
오른쪽이 모든 일에 더 빠른 것은 아니다. 외부 작업 하나는 자기 차례를 기다린다. 대신 짧은 검사에 쓸 자리를 보호한다. 이 비교의 목적은 모든 시간을 줄이는 것이 아니라, 어떤 일을 다른 일 때문에 밀리지 않게 할지 정하는 것이다.
“모여”에서는 정기 검사, DB 중심 작업, 외부 요청, 무거운 미디어 처리를 종류별로 나눠 실행한다. 한 번에 실행할 수 있는 작업은 각각 1·3·8·1개다. 작업마다 주로 사용하는 자원이 다르기 때문이다. 외부 응답 대기는 어느 정도 겹칠 수 있지만 영상 처리를 같은 개수만큼 겹치면 CPU와 메모리가 먼저 부족해질 수 있다.
작업을 큐에서 가져온 뒤 실행 자리 앞에서 너무 오래 기다리는 것도 막는다. 큐는 가져간 작업을 처리 중으로 보기 때문이다. 가져간 작업에는 처리 제한 시간이 있다. 실행 차례만 기다리다 그 시간을 다 쓰면 실제 처리를 시작하기도 전에 실패로 판단될 수 있다. 현재는 대기 상한을 넘으면 자리를 얻을 때까지 붙잡는 대신 작업을 미룬다.
이미지 변환은 외부 응답 대기와 다르다
“모여”에는 업로드한 이미지로 목록용 미리보기와 발행에 사용할 파생본을 만드는 작업도 있다. SNS 응답을 기다리는 것과 달리 이미지를 읽고, 크기를 줄이고, 다시 압축하는 동안에는 실제 계산이 필요하다. 압축된 파일이 작아도 펼친 픽셀을 메모리에 담는 데는 더 큰 공간이 들 수 있다.
현재는 Bun.Image로 변환한다. 실제 구현에서 WebP 파생본을 만드는 부분만 남기면 다음과 같다.
const resized = image.resize(
  output.targetWidthPixels,
  output.targetHeightPixels,
  { fit: "inside", withoutEnlargement: true },
);

const bytes = await resized.webp({ quality: output.quality }).bytes();tsBun 문서에 따르면 이렇게 결과를 await하는 이미지 변환은 JavaScript 실행 스레드 밖에서 처리된다. 앞 그림의 긴 동기 반복문처럼 콜백 실행을 직접 막는 것과는 다르다. 그래도 같은 서버의 CPU와 메모리를 사용한다. 비동기라는 이유로 여러 개를 한꺼번에 시작하면 계산량과 메모리 사용량이 겹친다.
그래서 이미지 변환과 영상 처리 같은 무거운 미디어 작업은 media_heavy라는 그룹에서 한 번에 하나씩 실행한다. 원본의 파일 크기와 픽셀 수에도 상한을 둔다. DB에서는 먼저 처리할 이미지를 확인하고 트랜잭션을 끝낸다. 그 뒤 변환·업로드를 수행하고, 결과를 저장할 때 다시 트랜잭션을 연다. 이미지 변환 내내 DB 연결까지 잡고 있을 필요는 없다.
외부 API 요청 여덟 개를 겹쳐도 괜찮다고 해서 이미지 변환 여덟 개도 괜찮은 것은 아니었다. 작업의 이름보다 실제로 무엇을 쓰는지 보고 실행 수를 정해야 했다.
할 일을 저장하는 곳도 필요했다
지금까지는 워커가 이미 가져온 일을 어떻게 실행할지 이야기했다. 그렇다면 그 일은 어디에 남겨둘까. 프로세스의 메모리 배열에 넣어두면 간단하지만, 서버가 재시작되는 순간 사라진다. 몇 시간 뒤에 발행할 게시물을 그 배열에만 보관할 수는 없다.
큐는 실행할 일을 기록해두고 처리할 쪽이 가져갈 수 있게 하는 장치다. API는 사용자의 요청을 접수하고 응답한다. 워커는 큐에서 일을 가져와 실행한다. 이렇게 나누면 사용자가 브라우저를 닫거나 API가 재시작돼도 저장된 일을 계속 발견할 수 있다.
여기서 큐를 도입했다고 처리 비용이 없어지는 것은 아니다. 일을 사용자 요청 밖으로 옮기는 것이다. 뒤에서 실행하는 워커에도 DB 연결, CPU, 메모리와 동시성 제한이 필요하다. 앞에서 본 풀 고갈은 큐가 없는 문제가 아니라, 큐에서 꺼낸 일을 실행하는 비용을 잘못 센 문제였다.
DB에 저장하고, 큐에 넣으면 끝일까?
예약 서비스를 만들면 보통 두 가지를 해야 한다. 게시물과 예약 상태를 DB에 저장하고, 실행 시각이 되면 발행할 작업을 큐에 등록한다. 두 저장을 따로 하면 중간에 프로세스가 멈췄을 때 문제가 생긴다. 다음 코드를 보자.
await db.transaction(async (tx) => {
  await saveScheduledPost(tx, post);
});

await externalQueue.add("publish", { postId: post.id });ts첫 저장이 끝난 직후 프로세스가 종료됐다고 생각해보자. DB에는 예약이 있다. 하지만 외부 큐에 넣는 줄은 실행되지 않았다. 화면에는 예약이 보이는데, 정작 그것을 실행할 작업이 없다.
큐에 먼저 넣으면 반대 문제가 생긴다. 워커가 일을 가져갔는데 DB 저장이 아직 끝나지 않았거나 실패했을 수 있다. 순서를 바꾸는 것만으로 두 저장소가 함께 성공하는 것은 아니다.
아래 그림의 왼쪽은 DB와 외부 큐에 따로 쓰는 경우다. 오른쪽은 예약과 작업 기록을 같은 DB 트랜잭션에 넣는 경우다. 먼저 저장 뒤 중단되는 장면을 보고, 이어서 커밋 전에 실패하는 장면을 보자.
첫 장면에서 왼쪽은 예약만 남는다. 오른쪽은 함께 커밋했으므로 예약과 실행할 일이 모두 남는다. 프로세스가 멈춰도 다른 워커가 기록을 발견할 수 있다. 다음 장면에서는 커밋 전에 실패했으므로 오른쪽의 두 기록이 함께 롤백된다.
중요한 것은 둘을 같은 트랜잭션으로 확정하는 것이다. 같은 DB를 사용해도 각각 따로 저장하면 중간에 프로세스가 멈췄을 때 한쪽만 남을 수 있다.
외부 메시지 큐를 쓴다면, 전달할 기록을 먼저 남긴다
Redis 기반 BullMQ나 SQS 같은 외부 큐를 사용할 수도 있다. 업무 DB와 작업 트래픽을 분리할 수 있고, 작업이 늘어나면 처리 워커를 늘릴 수도 있다. 다만 업무 저장과 외부 큐 등록 사이의 틈을 별도로 해결해야 한다.
트랜잭션 아웃박스 패턴은 이 문제를 푸는 방법이다. 업무 데이터를 저장하는 트랜잭션 안에 “외부 큐로 전달할 일”도 DB 행으로 남긴다. 별도 전달 프로세스가 그 행을 읽어 큐로 보낸다. 이름은 길지만 먼저 기억할 원리는 업무 저장과 전달할 기록을 같이 남긴다는 것이다.
전달 전에 중단되면 기록이 남아 있으므로 다시 시도한다. 전달에는 성공했는데 완료 표시 전에 중단되면 같은 일을 다시 보낼 수 있다. 따라서 중복으로 받은 작업을 안전하게 처리하고, 전달이 늦어지거나 실패했는지도 확인해야 한다. 이 패턴은 이전에 쓴 글에서 더 자세히 설명했다.
“모여”는 왜 pg-boss를 골랐나
“모여”는 이미 업무 데이터를 PostgreSQL에 저장했다. pg-boss도 같은 PostgreSQL에 작업을 저장하고, 업무 트랜잭션을 넘겨 같은 커밋 안에 등록할 수 있었다. 운영할 시스템을 늘리지 않고 예약 저장과 작업 등록을 함께 처리할 수 있다는 점이 좋았다.
| 선택지 | 함께 확인할 비용 | 업무 저장과 작업 등록의 연결 |
|---|---|---|
| Redis 기반 BullMQ | Redis 운영과 복구, DB에서 큐로 전달하는 경로 | 업무 DB의 outbox와 전달 단계를 설계 |
| SQS 같은 외부 큐 | 큐와 전달 지연·실패, 중복 처리 | 업무 DB의 outbox와 전달 단계를 설계 |
| pg-boss | 업무 DB 안에서 큐 조회·정리도 실행 | 같은 PostgreSQL 트랜잭션으로 등록 가능 |
당시 비교한 BullMQ는 Redis 기반 구성이다. 현재는 PostgreSQL 백엔드도 제공하므로, 새로 선택한다면 이 구성까지 비교해볼 수 있다.
실제 큐 어댑터는 업무 트랜잭션이 전달되면 fromDrizzle로 pg-boss에 넘긴다. 등록 코드에서 예약 시각과 중복 방지 옵션을 덜어내면 다음과 같다. 강조한 줄이 작업 등록에 같은 트랜잭션을 전달하는 부분이다.
const jobId = await this.#client.send(
  command.queue.name,
  { correlation: command.correlation, payload: command.payload },
  {
    id: command.id,
    ...(transaction === null ? {} : { db: fromDrizzle(transaction, sql) }),
  },
);ts트랜잭션이 있는 경로에서 업무 행과 작업 행이 함께 확정된다. 롤백했을 때 큐 작업도 남지 않는지는 통합 테스트로 확인한다. 같은 트랜잭션을 넘기는 사용법은 pg-boss의 어댑터 문서에 설명돼 있다.
여기서는 pg-boss 작업 행이 실행할 일을 보관한다. 업무 데이터와 같은 트랜잭션에 넣을 수 있어, 별도 outbox 테이블에서 외부 큐로 전달하는 단계를 줄였다.
같은 DB를 쓰면 그만큼 추가되는 일도 있다. 큐를 조회하고 스케줄을 검사하고 통계를 모으는 부하가 업무 DB에 더해진다. Redis를 따로 운영하지 않는 대신 PostgreSQL이 큐의 일도 맡는 것이다. 큐의 유지보수 주기와 연결도 전체 예산에 포함해야 한다.
예약과 작업을 함께 저장해도 SNS 발행이 반드시 한 번만 일어나는 것은 아니다. SNS에 게시물을 발행한 직후 결과 저장 전에 중단될 수 있다. 다시 실행할 때 이미 발행했는지 확인하고 중복 부작용을 막는 설계는 여전히 필요하다. “작업을 함께 남긴다”와 “외부 작업을 정확히 한 번 수행한다”는 다른 보장이다.
알림을 놓쳐도 작업은 남아야 한다
큐에 작업을 저장했다면 워커가 새 일을 발견해야 한다. 계속 DB를 조회하면 찾을 수 있지만, 할 일이 없을 때도 조회한다. 주기를 길게 두면 비용은 줄지만 새 작업의 발견이 늦어진다.
여기에 알림을 같이 쓰면 좋다. 새 작업이 생겼다는 신호를 받고 DB를 확인하는 것이다. PostgreSQL에는 특정 채널의 신호를 듣는 LISTEN과 신호를 보내는 NOTIFY, pg_notify()가 있다. “모여” 워커는 pg-boss의 이 경로를 사용한다.
하지만 알림과 작업 기록을 같은 것으로 보면 안 된다. 아래 그림에서 워커의 알림 연결이 끊겼을 때 무엇이 남는지 보자.
워커가 연결해 듣고 있지 않으면 알림을 받지 못한다. 나중에 연결했다고 놓친 알림을 모두 다시 전달받는 구조는 아니다. 반면 커밋한 작업 행은 DB에 남아 있다. 재연결한 워커가 주기 조회로 그 행을 발견하면 실행할 수 있다.
알림은 DB를 다시 확인하라는 신호다. 실행할 일은 DB 기록에 남아 있으므로, 신호를 받지 못했다고 할 일이 없다고 판단하지 않는다.
트랜잭션 안에서 보낸 NOTIFY는 커밋 뒤에 전달되고, 롤백되면 전달되지 않는다. 저장이 아직 확정되지 않았는데 알림만 먼저 보내 실행하는 순서를 피할 수 있다. 이 동작은 PostgreSQL NOTIFY 문서에 명시돼 있다.
미래 예약은 시각이 지나야 실행할 수 있다
오후 3시에 발행할 작업을 오전에 저장했다고 생각해보자. 저장할 때 알림을 보낼 수는 있지만, 지금은 실행할 시각이 아니다. 이후 시계가 3시를 가리켰다고 DB가 저절로 새 NOTIFY를 보내는 것도 아니다.
그래서 미래 예약을 발견하려면 실행할 시각이 됐는지 확인하는 조회가 필요하다. “새 행이 들어옴”과 “이미 있는 행이 지금 실행 가능해짐”은 다른 사건이다. 예약 큐에서 알림만으로 충분하지 않은 이유다.
“모여”는 알림과 주기 조회를 함께 사용한다. 일반 큐는 알림을 놓쳐도 작업을 찾도록 30초마다 확인하고, 예약 발행 등 시각이 중요한 일부 작업은 5초 간격이다. 리스너가 연결되지 않았을 때의 조회 경로도 따로 있다.
조회 간격을 줄이면 발견은 빨라지지만 DB에 보내는 확인도 늘어난다. 큐마다 아무 작업이 없어도 주기적으로 확인한다면 사용자와 무관한 고정 부하가 생긴다. 작은 DB에서는 이 비용도 무시할 수 없다.
풀을 늘리기 전에 확인할 것들
풀 고갈을 겪으면 연결 수를 늘리고 싶어진다. 실제로 연결 예산이 부족했다면 필요한 변경일 수 있다. 하지만 무엇 때문에 부족한지 모른 채 숫자만 늘리면, 같은 구조가 더 큰 상한에서 반복될 수 있다.
먼저 느린 부분을 나눈다. 작업이 큐에서 아직 기다리는지, 워커 실행 차례를 기다리는지, 연결을 기다리는지, 연결을 얻은 뒤 쿼리나 락에서 기다리는지다. 이 단계들은 모두 처리 시간을 늘리지만 해결할 위치는 다르다.
| 보이는 상황 | 다음에 확인할 곳 |
|---|---|
| DB CPU 사용률은 낮은데 연결을 오래 기다린다 | 프로세스별 풀 점유, 작업 내부의 동시 호출, 연결을 쓰는 시간 |
| 연결은 얻었는데 처리가 오래 걸린다 | 쿼리 실행, 락 대기, 트랜잭션 안의 외부 호출 |
| 풀에 여유가 있는데 정기 작업이 밀린다 | 워커의 동시 실행 수와 작업 종류별 대기 |
| 특정 순간에 대기가 갑자기 늘어난다 | 정기 작업의 등록 시각, 같은 대상에 몰린 작업, 재시도 시각 |
지금은 역할별 연결을 따로 센다
현재 “모여”는 API 한 개와 워커 한 개를 같은 EC2에서 실행하고, RDS는 db.t4g.small을 사용한다. 처음에는 db.t4g.micro로 시작했고, 뒤에서 설명할 메모리 부족 장애를 겪은 뒤 사양을 올렸다.
이 구성에서 API의 업무 풀, 워커의 업무 풀, pg-boss가 작업을 관리하는 풀, 알림을 계속 듣는 연결을 따로 센다. 모두 같은 PostgreSQL로 가지만 사용하는 이유와 연결의 수명이 다르다.
API는 업무 풀 4개, pg-boss 풀 2개, 변경 알림 리스너 1개로 최대 7개다. 워커는 업무 풀 14개, pg-boss 풀 2개, 큐 알림 리스너 1개로 최대 17개다. 두 프로세스의 운영 상한을 합하면 24개다.
여기에 마이그레이션 4개와 운영자 점검 5개의 여유를 더해 33개를 계획한다. 항상 33개를 열어놓는다는 뜻은 아니다. 여러 경로가 함께 사용할 때 허용할 상한과 점검 여유를 합친 숫자다.
연결만 계획하지도 않는다. 작업을 동시에 몇 개 실행할지, 각 작업이 DB 호출을 몇 개 겹칠지, 미디어 작업이 CPU와 메모리를 얼마나 쓸지를 함께 정한다. 작업의 동시 실행 수와 연결 상한을 하나의 설정에서 관리하고, 서버가 시작할 때 DB에서 사용할 수 있는 연결 수와 비교한다.
현재 설정의 계산을 조금 더 자세히 보면
워커 업무 풀 14개는 동시에 실행할 작업 13개에 연결 하나씩을 붙인 값이 아니다. 정기 검사 1자리와 DB 중심 3자리에 작업당 동시 트랜잭션 2개를 계산하면 8개다. 상태 점검용 연결 1개를 더하고, 외부 요청 8자리와 미디어 1자리에 ceil(9 / 2) = 5개를 배정한다. 합계는 14개다.
외부 요청과 미디어 작업은 처리 내내 DB 연결을 쓰지 않으므로, 두 작업당 연결 하나를 배정했다. 실제 호출이 몰리는 순간에는 이 계산보다 많은 연결이 필요할 수 있다. 정기 작업이 몰리거나 같은 채널의 수집이 겹치거나 워커 수가 바뀌면 실제 점유와 대기를 다시 확인해야 한다.
실행 자리는 정기 검사 1, DB 중심 3, 외부 요청 8, 미디어 1이다. 외부 요청 중 댓글 동기화는 최대 4자리만 써서 다른 외부 작업의 자리를 남긴다. 실행 자리와 연결 수를 같은 숫자로 세지 않는다.
DB 연결 경보선은 계획 33개의 1.5배를 올림한 50개다. 이는 DB의 max_connections가 아니라 운영 기준이다. API 업무 풀의 유휴 연결 수명은 10초, 워커는 120초다. 연결이 필요할 때 생성되고 유휴 상태에서 정리되므로 관측값은 설정한 최대치보다 낮을 수 있다.
현재 API 컨테이너의 한도는 CPU 0.75코어와 메모리 1GiB, 워커는 CPU 1.25코어와 메모리 1.5GiB다. EC2는 t4g.medium이다. AWS 리소스는 Terraform으로 관리하고 Cloudflare 웹은 Wrangler로 배포한다. 서버의 공개 인바운드는 닫고 Tunnel과 SSM을 사용한다.
프록시를 추가하기 전에 고칠 부분도 있다
PgBouncer나 RDS Proxy처럼 연결을 중간에서 관리하는 도구도 있다. 프로세스가 많아지고 DB 연결 생성과 재사용이 병목이 되는 상황에서는 검토할 가치가 있다. 하지만 내 프로세스의 풀 상한을 건너뛰게 해주는 도구는 아니다.
워커가 여덟 연결을 모두 빌린 채 기다리고 있다면 그 뒤에 프록시를 둬도 아홉 번째 호출은 먼저 로컬 풀의 빈자리를 기다린다. 한 작업이 여러 연결을 동시에 요구하거나, 연결을 잡고 외부 응답을 기다리는 문제도 그대로 남는다.
또한 알림을 듣는 LISTEN처럼 세션을 유지해야 하는 경로가 있다. PgBouncer의 기능 표는 연결을 재사용하는 모드에 따라 지원되는 세션 기능을 구분한다. 지금 무엇을 공유하고 무엇이 연결을 계속 붙잡는지 확인한 뒤 선택해야 한다.
그래서 첫 장애에서는 프록시를 먼저 추가하기보다, 작업 안의 동시 호출과 락 대기를 줄이고 전체 연결 예산을 맞췄다. 앞으로 API나 워커 복제본이 늘거나 DB 연결 자체의 한계에 가까워지면 다른 선택지를 다시 비교할 수 있다.
그렇다고 작은 DB가 계속 충분한 것은 아니다
이 원인을 고쳤다고 작은 DB에서 다른 문제가 사라진 것은 아니었다. 다음 날에는 RDS가 메모리 부족으로 멈췄다가 복구됐고, 워커 재연결에도 문제가 있었다. 첫날의 내부 풀 고갈과는 다른 장애였다.
당시 연결은 최대 9개였다. 연결 개수만으로 설명할 일이 아니었다. pg-boss 통계 주기를 60초에서 15초로 줄인 변경은 전체 작업 집계를 네 배 자주 실행하게 했다. 통계 주기를 되돌리고 RDS를 small로 올렸다. 끊긴 연결을 감지하고 다시 연결하는 코드도 보완했다.
동시에 필요한 연결 수를 잘못 셌을 때는 호출 수를 제한하고 연결을 잡고 기다리는 시간을 줄여야 했다. 메모리가 부족한 문제에서는 DB 사양과 고정 부하도 봐야 했다. 첫 장애의 해결책이 다음 장애에서도 통하는 것은 아니었다.
이제는 어디서 기다리는지부터 본다
처음에는 독립적인 일에 Promise.all을 붙이면 빨라질 거라고 생각했다. 작업 네 개를 실행하면 연결도 네 개쯤 쓰겠거니 했다. 하지만 코드를 따라가니 한 작업이 여러 연결을 동시에 빌렸고, 기다리는 동안에도 그 연결을 잡고 있었다. 함수의 개수 대신 실제로 사용하는 자원을 세어야 했다.
필요한 연결 수는 동시에 시작하는 호출 수와 연결을 쓰는 시간에 달려 있다. 일을 뒤로 넘기는 큐는 실행 기록을 보관하지만 그 일을 처리할 비용까지 없애지는 않는다. 알림은 기록을 빨리 발견하게 해주지만 기록 자체를 대신하지 않는다.
아직 출시 전이라 사용자는 나 하나다. 그래도 이제 그 한 명 뒤에서 얼마나 많은 일이 생기는지, 그 일이 어디에서 기다리는지, 기다리는 동안 무엇을 잡고 있는지부터 본다. 운영 비용을 아끼려면 서버 사양만 낮춰서는 안 됐다. 작은 서버에 맞춰 한 번에 시작할 일을 제한하고, 필요 없어진 연결은 빨리 돌려줘야 했다.