로그인 버튼 뒤에서 고민한 것들
대부분의 서비스는 회원가입과 로그인에서 시작한다. 이메일과 비밀번호만 확인하면 끝날 것 같지만, 막상 구현해 보면 예상하지 못한 허점이 드러나고 고민해야 할 문제도 늘어난다.
새로고침해도 로그인을 유지하려면 어떻게 해야 할까? 누군가 계정을 훔쳤다면, 이미 로그인한 기기를 어떻게 내보낼까? HTTP와 쿠키, 브라우저와 서버가 요청을 주고받는 방식을 알아야 판단할 수 있는 문제다.
최근 쿠팡의 개인정보 유출, 티빙의 침해사고, 정부24의 개인정보 유출 소식을 보며 남의 서비스만 탓할 일은 아니라는 생각이 들었다.
이번에 모여를 만들면서는 사용자의 계정과 데이터를 어떻게 보호할지 공부하고, 실제 구현에도 반영했다. 완벽한 보안이라고 말할 수는 없지만, 주어진 시간과 비용 안에서 가능한 부분은 최대한 챙기고 싶었다.
계정을 지키는 일은 요금제와도 이어졌다. 모여에는 팀 플랜이 있다. 팀원이 계정 하나를 함께 쓰면 각자의 권한을 나눈 의미도, 요금제를 설계한 전제도 약해진다.
넷플릭스처럼 구독료를 받는 서비스에서 여러 사람이 계정 하나를 공유하면 사용자는 비용을 아낄 수 있다. 하지만 운영자는 이용이 늘어나는 만큼 서버와 데이터베이스 비용을 계속 부담한다. 서비스를 안정적으로 운영하고 더 좋은 콘텐츠와 기능을 제공하려면 이 비용을 감당할 수익이 필요하다. 그래서 요금제를 설계할 때 정한 이용 범위 안에서 서비스가 쓰이도록 관리해야 한다.
계정 공유를 관리하기 위해 활성 세션 수에도 제한을 두었다. 다만 한 사람도 여러 기기와 브라우저를 오가며 사용할 수 있으므로, 세션을 하나만 허용하는 것은 현실적이지 않았다. 이런 사용성을 고려해 한 계정의 활성 세션을 최대 5개로 제한했다.
추후 사용 패턴을 살펴보고, 활성 세션의 최대 개수를 줄이는 방향도 검토할 예정이다.
이 글은 로그인 이후 요청이 오가는 흐름을 중심으로 모여의 인증 설계를 정리한 기록이다. SSR 인증부터 다중 기기 관리와 강제 로그아웃, 서버 확장과 보안에 드는 비용까지 이어서 설명한다.
모여의 프론트엔드는 TanStack Start, 백엔드는 NestJS이고, 둘 사이 통신에는 oRPC를 사용한다. 웹은 Cloudflare Workers에서, API는 AWS EC2에서 실행된다. 이 배치는 뒤에서 인증 요청이 지나는 경로와 비용을 이야기할 때 다시 등장한다.
한 번 로그인했는데, 다음 요청은 어떻게 알아볼까?
사용자가 노트북에서 모여에 로그인하면 서버는 이메일로 계정을 찾고 비밀번호를 확인한다. 여기까지는 익숙한 과정이다. 그런데 사용자가 다음 화면을 열면 서버에는 새로운 HTTP 요청이 도착한다. 이전에 비밀번호를 확인했다는 사실만으로 이 요청의 주인이 같은 사람이라고 알 수는 없다.
매번 비밀번호를 보내는 대신, 모여는 로그인에 성공했을 때 로그인 기록과 그 기록을 찾을 토큰을 만든다. 서버에 남기는 로그인 기록이 세션이다. 세션에는 사용자의 ID와 유효기간, 종료 여부 같은 정보를 저장한다.
서버는 발급한 토큰을 브라우저에 전달한다. 이후 요청에 그 토큰이 포함되면, 연결된 세션이 여전히 유효한지 확인한다.
아래 도식은 비밀번호로 인증하는 첫 로그인과 토큰으로 세션을 조회하는 이후 요청의 차이를 보여준다. TanStack Start 같은 SSR 프레임워크를 거치는 경우는 뒤에서 따로 다루고, 여기서는 기본 흐름만 본다.
DB의 세션이 유효하면 그 사용자의 요청으로 처리한다.
다음 요청에는 비밀번호를 다시 보내지 않는다전체 과정을 글로 보기
- 처음에는 비밀번호를 확인한다
서버가 이메일로 계정을 찾고 비밀번호를 확인한다.
- 서버에 로그인 기록을 만든다
새 토큰과 연결된 세션을 저장한다. 어느 사용자이며 언제 끝나는지 기록한다.
- 토큰을 브라우저에 전달한다
브라우저는 전달받은 토큰을 쿠키에 보관한다.
- 다음 요청에는 쿠키가 붙는다
다음 화면을 열 때는 비밀번호 대신 쿠키의 토큰을 보낸다.
- 같은 사용자의 세션인지 확인한다
DB의 세션이 유효하면 그 사용자의 요청으로 처리한다.
처음 로그인할 때는 비밀번호를 확인하고, 그다음 요청부터는 세션을 조회한다. 화면을 이동할 때마다 비밀번호를 다시 검증하지는 않는다.
모여가 발급하는 값은 Opaque Token(불투명 토큰)이다. 예측하기 어려운 무작위 문자열로, 토큰 자체에는 이메일이나 권한 같은 사용자 정보가 담겨 있지 않다. 서버는 PostgreSQL에 저장된 세션을 조회해 로그인 상태를 확인한다.
인증 코드의 핵심 흐름만 남기면 다음과 같다. tokenIssuer는 토큰을 조회용 값으로 바꾸고, sessions는 이 값으로 DB의 세션을 찾는다.
async function authenticate(rawToken: string, now: Date) {
  const tokenDigest = tokenIssuer.digestToken(rawToken);
  if (tokenDigest === null) {
    return { status: "authentication_required" };
  }

  const record = await sessions.findByTokenDigest(tokenDigest);
  if (record === null || !record.session.getStatus(now).isActive) {
    return { status: "authentication_required" };
  }

  return { status: "authenticated", session: record.session };
}ts토큰이 있다는 것과 로그인 상태가 유효하다는 것은 다르다. 서버가 기록을 확인하므로, 나중에 문제가 생겼을 때 특정 세션만 골라 끝낼 수도 있다. 세션을 서버에서 관리하기로 한 데는 이 점이 가장 컸다.
구현 더 보기: 토큰 저장과 소셜 로그인
브라우저에 줄 값과 DB에 남길 값을 나눈다
브라우저에는 무작위로 만든 토큰을 보내지만, DB에는 그 토큰을 그대로 저장하지 않는다. 토큰을 가진 사람은 해당 세션으로 요청할 수 있으므로, DB에 남기는 값도 구분하고 싶었다.
서버는 비밀 키와 토큰을 HMAC에 넣어 Digest를 계산한다. 같은 키와 같은 토큰을 넣으면 같은 Digest가 나온다. 따라서 다음 요청에서 토큰을 받았을 때도 같은 계산을 하면, DB에 저장한 세션을 찾을 수 있다. 아래 그림은 브라우저에 보관하는 값과 DB에 저장하는 값의 차이를 보여준다.
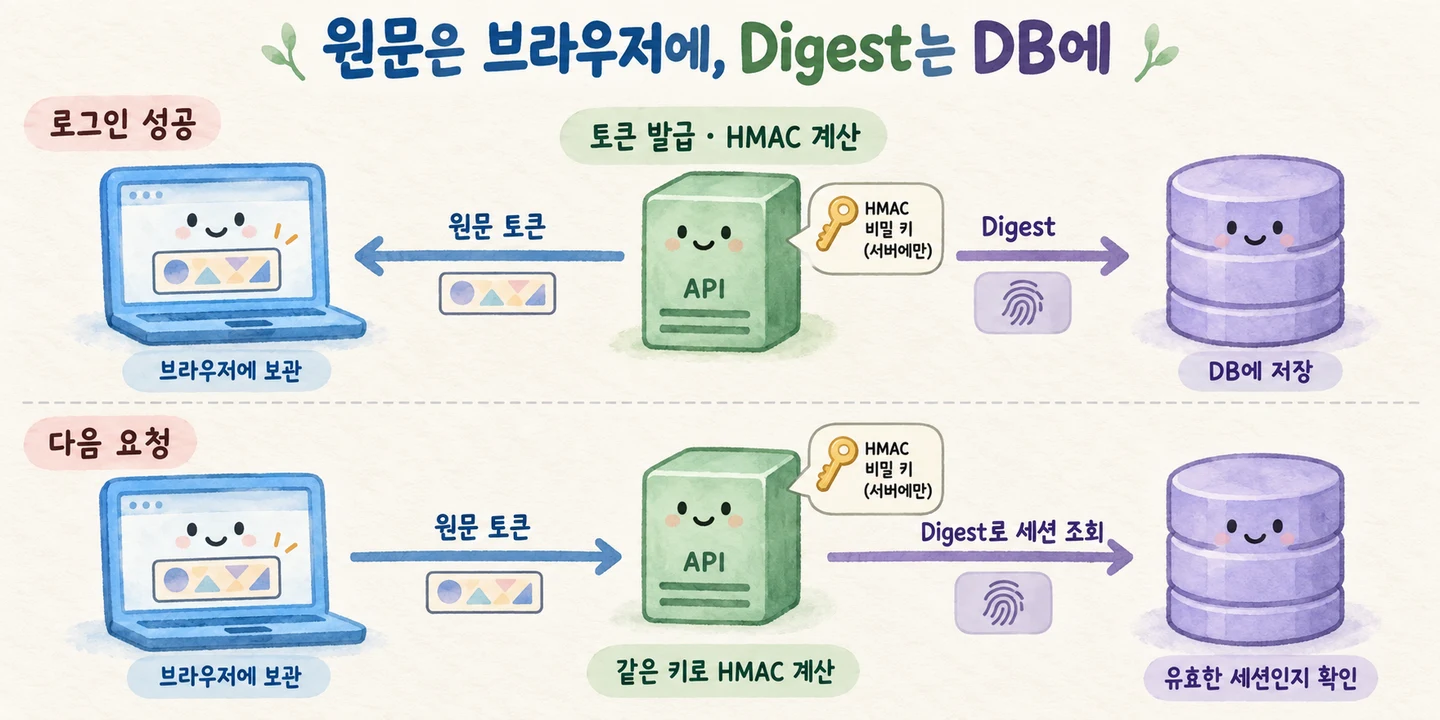
Digest는 원본 값을 해시 함수로 계산한 고정 길이의 결과다. HMAC은 이 계산에 비밀 키를 함께 넣는 방식이다.
const randomToken = randomBytes(32).toString("base64url");
const rawToken = `v${keyring.activeVersion}.${randomToken}`;
const tokenDigest = keyring.digestWithActiveSecret(rawToken);

return { rawToken, tokenDigest };tsDB에 저장한 Digest를 브라우저의 토큰 대신 쓸 수는 없다. 반대로 브라우저의 원문 토큰이 탈취되면 그 세션으로 요청할 수 있으니, 서버의 HMAC 키와 원문 토큰은 각각 보호해야 한다.
키를 바꾸는 것과 토큰을 갱신하는 것은 다르다
모여는 토큰을 32바이트 난수로 만들고, 앞에 사용한 HMAC 키의 버전을 붙인다. 키를 교체한 뒤에도 어떤 키로 Digest를 계산해야 하는지 알기 위한 정보다. 액세스 토큰과 리프레시 토큰을 번갈아 갱신하는 구조와는 관계가 없다.
세션 토큰과 기기 인식 토큰은 같은 HMAC 키를 사용하지만, Digest를 계산할 때 각 토큰의 용도를 구분하는 문자열을 함께 넣는다. 그래서 토큰 원문이 같더라도 용도가 다르면 서로 다른 Digest가 만들어진다.
소셜 로그인도 모여의 세션으로 이어진다
Google·Kakao로 로그인해도 마지막에는 모여의 세션을 만든다. 소셜 계정으로 본인을 확인하는 과정이 앞에 추가될 뿐, 이후 요청에서는 같은 방식으로 모여의 세션을 조회한다. 소셜 제공자가 발급한 API 토큰을 그대로 모여의 로그인 토큰으로 쓰지는 않는다.
중간에 오가는 요청과 응답이 정말 같은 로그인 과정인지도 확인해야 한다. 아래 값과 처리가 각각 이 확인을 나눠 맡는다.
| 확인하는 값이나 처리 | 확인하려는 것 |
|---|---|
state | 돌아온 응답이 우리가 시작한 로그인 요청과 연결되는가? |
| 브라우저 바인딩 | 로그인을 시작한 브라우저에서 이어지는 요청인가? |
nonce | 받은 ID 토큰이 이번 로그인 과정에서 발급된 것인가? |
| PKCE | 인가 코드를 가로채더라도 로그인 시작 시 준비한 값 없이 토큰으로 교환하지 못하게 하는가? |
| 일회성 처리 | 이미 처리한 로그인 응답을 다시 사용하지 못하게 하는가? |
이메일이 같다고 계정을 바로 합치지 않는다
이메일로 가입한 사용자가 같은 주소의 Google 계정으로 로그인하면 어떻게 할까? 주소 문자열만 보고 두 계정을 합치면, 남의 이메일로 소셜 계정을 만든 사람이 기존 계정에 들어올 수 있다.
그래서 소셜 제공자가 그 이메일을 확인했다고 알려 준 경우에만 기존 계정에 자동으로 연결하고 로그인시킨다. 코드에서는 이 판단을 verifiedEmail로 받고, 연결과 로그인이 함께 일어난 결과는 일반 로그인과 구분해 linked_and_signed_in으로 남긴다.
확인했다는 근거는 제공자마다 다르다. Google은 서명을 검증한 ID 토큰의 email_verified와 함께 Gmail 주소인지, Workspace 도메인(hd)인지를 보고, Kakao는 email_verified를 본다. 확인되지 않은 주소라면 자동 연결도, 새 가입도 하지 않는다.
기존 모여 계정 쪽 이메일도 언제나 확인된 주소다. 이메일로 가입하면 먼저 그 주소로 링크를 보내고, 링크를 연 화면에서 비밀번호와 프로필까지 제출해야 가입이 끝난다. 링크를 여는 것만으로는 가입이 완료되지 않는다. 확인하지 않은 계정이 생기지 않으니, 이메일 확인 여부를 따로 저장할 필요도 없었다.
이렇게 계정 하나에 이메일·비밀번호·소셜 계정이 함께 붙을 수 있으니, 어떤 로그인 방법이 있는지는 GET /auth/login-methods 하나로 읽는다. 이메일, 비밀번호 등록 여부, 제공자별 소셜 연결 여부를 한 응답에 담아 화면마다 로그인 수단을 따로 추측하지 않게 했다.
로그인 정보를 브라우저에 맡겨도 괜찮을까?
브라우저가 토큰을 보관했다면, 다음 요청에는 그 토큰을 담아 서버로 보내야 한다. 모여에서는 토큰을 보관하고 전달하는 데 쿠키를 사용한다. 서버가 응답의 Set-Cookie 헤더에 토큰을 담아 보내면 브라우저는 이를 쿠키로 저장한다. 이후 조건에 맞는 요청을 보낼 때는 저장한 쿠키를 Cookie 헤더에 담아 함께 보낸다.
여기서 쿠키와 세션은 경쟁하는 선택지가 아니다. 세션은 서버의 로그인 기록이고, 쿠키는 그 기록을 찾을 토큰을 보관하고 전달하는 수단이다. JWT도 쿠키에 넣을 수 있다.
토큰을 가진 사람은 해당 세션으로 요청을 보낼 수 있다. 그래서 JavaScript가 토큰을 직접 읽지 못하게 하고, 쿠키가 전송되는 조건도 제한했다.
const cookie = fastifyCookie.serialize(cookieName, rawToken, {
  httpOnly: true, // JavaScript로 쿠키 값을 읽지 못하게 한다.
  secure: isSecure, // HTTPS에서만 전달한다. 운영에서는 true다.
  sameSite: "lax", // 다른 사이트에서 시작한 전송을 제한한다.
  path: "/",
  expires: expiresAt,
});

responseHeaders.append("set-cookie", cookie);ts세 설정이 막는 것은 각각 다르다.
| 설정 | 제한하는 것 | 모여에서의 의미 |
|---|---|---|
HttpOnly | JavaScript가 쿠키 값을 읽을 수 있는가? | 브라우저의 코드로 토큰을 직접 읽지 못하게 한다 |
Secure | 어떤 통신으로 쿠키를 보낼 것인가? | HTTPS 요청에서만 쿠키를 보낸다 |
SameSite=Lax | 다른 사이트에서 시작한 요청에도 붙일 것인가? | 쿠키를 보내는 상황을 제한한다 |
HttpOnly는 악성 스크립트가 쿠키를 읽어 훔쳐 가는 세션 하이재킹의 한 경로를 줄인다. 다만 막는 것은 쿠키 값을 읽는 경로 하나뿐이다. XSS로 실행된 악성 스크립트는 쿠키 값을 읽지 못해도, 사용자의 브라우저에서 인증된 요청을 보낼 수는 있다. 그래서 쿠키 속성과 함께 입력·출력 처리와 요청 검증도 챙겨야 한다.
SameSite를 지정하지 않은 쿠키를 어떻게 다룰지는 브라우저마다 다를 수 있다. 그래서 모여는 기본값에 기대지 않고SameSite=Lax를 직접 지정한다. 브라우저별 지원 현황은 Can I Use에서 볼 수 있다.
구현 더 보기: 쿠키의 범위와 만료
쿠키를 어느 주소에 보낼지 정한다
운영 쿠키 이름은 __Host-moyeo-session이다. 이름 앞의 __Host-는 브라우저가 쿠키 설정을 더 엄격하게 확인하도록 하는 접두사다. Secure가 있어야 하고, 경로는 Path=/이어야 하며, Domain을 지정하면 안 된다. 모여는 운영 환경에서 이 조건을 충족하지 못하면 쿠키를 아예 발급하지 않는다.
Domain을 지정하지 않았으므로 응답을 받은 호스트의 쿠키가 된다. moyeo.io에 저장한 쿠키는 api.moyeo.io 요청에 붙지 않는다. 두 서버 사이의 전달은 다음 절에서 설명하는 프록시가 맡는다.
쿠키가 남아 있어도 로그인은 끝날 수 있다
모여는 Expires로 만료일을 지정하므로 브라우저를 닫았다가 열어도 쿠키가 남을 수 있다. 이런 쿠키를 영속 쿠키라고 한다. 반면 만료일을 지정하지 않는 “세션 쿠키”는 보통 브라우저 세션 동안 사용하는 쿠키를 뜻한다. 여기서 말하는 서버의 로그인 기록인 세션과는 다른 의미다.
브라우저가 쿠키를 보관하는 기간과 서버가 로그인을 허용하는 기간도 다르다. 쿠키가 남아 있더라도 서버의 세션이 만료되거나 종료됐다면 인증할 수 없다.
새로고침해도 로그인은 이어져야 한다
지금까지는 브라우저와 API 서버가 직접 대화하는 것처럼 설명했다. 모여의 실제 요청 경로에는 Cloudflare Workers에서 실행되는 TanStack Start 서버(moyeo-web)가 하나 더 있다.
브라우저는 moyeo.io/api/v1으로 요청한다. TanStack Start의 서버 라우트가 이 요청을 NestJS API인 api.moyeo.io로 중계한다. 이렇게 요청과 응답을 대신 전달하는 역할이 프록시다. oRPC는 공유한 API 계약을 바탕으로 요청을 만드는 통신 계층이며, 실제 인증 정보는 HTTP 헤더로 오간다.
로그인 응답은 브라우저까지 돌아와야 한다
NestJS가 로그인을 처리하고 응답에 Set-Cookie를 넣었다면, TanStack Start도 이 헤더를 브라우저에 전달해야 한다. 브라우저가 실제로 받는 것은 TanStack Start의 응답이기 때문이다. 아래 도식은 NestJS의 Set-Cookie 응답이 TanStack Start를 거쳐 브라우저에 도달하는 과정을 보여준다.
TanStack Start가 받은 쿠키를 응답에 넣어 브라우저로 보낸다.
쿠키는 브라우저가 받은 응답의 호스트에 저장된다전체 과정을 글로 보기
- 브라우저는 moyeo.io로 요청한다
웹 페이지와 같은 호스트의 /api/v1 로그인 경로를 호출한다.
- TanStack Start가 NestJS로 중계한다
서버 라우트가 API 원본에 요청을 전달한다.
- NestJS가 Set-Cookie를 응답한다
로그인 성공 후 세션 토큰을 쿠키로 설정할 응답을 보낸다.
- 브라우저까지 Set-Cookie를 돌려준다
TanStack Start가 받은 쿠키를 응답에 넣어 브라우저로 보낸다.
브라우저는 moyeo.io의 응답에 포함된 Set-Cookie에 따라 쿠키를 저장한다. 이후 moyeo.io/api/v1으로 API 요청을 보내면 저장한 쿠키도 함께 전송한다. TanStack Start는 이 쿠키를 포함한 요청을 NestJS로 중계한다.
모여에서는 프록시가 응답을 전달할 때 Set-Cookie가 누락되지 않도록 처리했다. 아래 코드의 isSafeCookie는 Domain·Secure·SameSite 등의 전달 조건을 확인하는 함수다.
const cookies = upstreamHeaders.getSetCookie();

for (const cookie of cookies) {
  if (!isSafeCookie(cookie, publicUrl)) {
    throw new Error("API가 안전하지 않은 cookie를 반환했습니다.");
  }

  responseHeaders.append("set-cookie", cookie);
}tsSSR은 다른 서버 요청을 만든다
로그인한 상태에서 페이지를 새로고침하면, TanStack Start가 페이지를 만들면서 API 데이터를 먼저 조회할 수 있다. 서버에서 HTML을 만드는 이 과정이 SSR이다. 이때 API를 호출하는 주체는 브라우저가 아니라 TanStack Start 서버다.
브라우저의 JavaScript는 localStorage를 읽을 수 있지만, SSR 서버는 사용자의 localStorage에 접근할 수 없다. localStorage에 저장된 값이 페이지 요청에 자동으로 포함되는 것도 아니다. 반면 쿠키는 조건에 맞는 페이지 요청에 함께 전송되므로, SSR 서버가 요청 헤더에서 읽을 수 있다.
페이지 요청에 담긴 쿠키는 API 요청으로 자동 전달되지 않는다. TanStack Start가 브라우저 요청의 Cookie를 읽어 NestJS 요청 헤더에 직접 넣어야 한다. 아래 도식은 두 요청 사이에서 Cookie를 전달하는 과정을 보여준다.
TanStack Start가 그 사용자의 데이터를 담은 페이지를 만든다.
SSR 서버는 사용자의 localStorage를 읽지 않는다전체 과정을 글로 보기
- 새로고침 요청에도 쿠키가 온다
브라우저가 페이지를 요청하며 저장해 둔 쿠키를 함께 보낸다.
- 새 API 요청에 Cookie를 직접 넣는다
TanStack Start가 페이지 요청에서 읽은 Cookie를 API 요청 헤더에 넣는다.
- 그 사용자의 데이터를 돌려준다
NestJS는 세션을 확인한 뒤 해당 사용자의 조회 결과를 반환한다.
- 데이터로 HTML을 만들어 응답한다
TanStack Start가 그 사용자의 데이터를 담은 페이지를 만든다.
NestJS는 전달받은 토큰으로 같은 사용자의 세션을 확인한다. TanStack Start는 그 사용자의 데이터를 받아 HTML을 만든다. 브라우저에서 버튼을 눌렀을 때와 SSR에서 데이터를 읽을 때 모두 같은 로그인 기록으로 인증하는 셈이다.
아래 예시는 쿠키를 읽어서 API 클라이언트의 요청 헤더에 넣는 부분만 남겼다. createApiClient는 모여에서 oRPC 클라이언트를 만드는 함수다.
function createServerApiClient(request: Request, apiOrigin: string) {
  const headers: Record<string, string> = {};
  const cookie = request.headers.get("cookie");

  if (cookie !== null) {
    headers.cookie = cookie;
  }

  return createApiClient({
    baseUrl: apiOrigin,
    // 실제로는 createApiOriginRequest로 헤더를 정리한 뒤 보낸다
    fetch: (apiRequest) => fetch(apiRequest),
    headers,
  });
}ts서버에서 실행되는 fetch는 사용자의 브라우저 쿠키 저장소에 접근할 수 없다. 그래서 credentials: "include"를 설정해도 페이지 요청에 담긴 쿠키가 API 요청으로 넘어가지 않는다. 위 코드처럼 들어온 Cookie를 읽어 새 요청의 헤더에 직접 넣어야 한다.
실제 코드에서는 이 함수를 TanStack Start의 createServerOnlyFn으로 감싸 서버에서만 실행되게 했고, 지금 처리 중인 페이지 요청은 getRequest()로 읽는다.
프록시를 거치면 느려지지 않을까?
브라우저가 NestJS를 직접 호출하는 것과 비교하면, TanStack Start를 거치는 요청에는 서버 간 호출이 하나 더 생긴다. 중계 처리와 네트워크 왕복에 시간이 들고, 문제가 생길 수 있는 지점도 늘어난다.
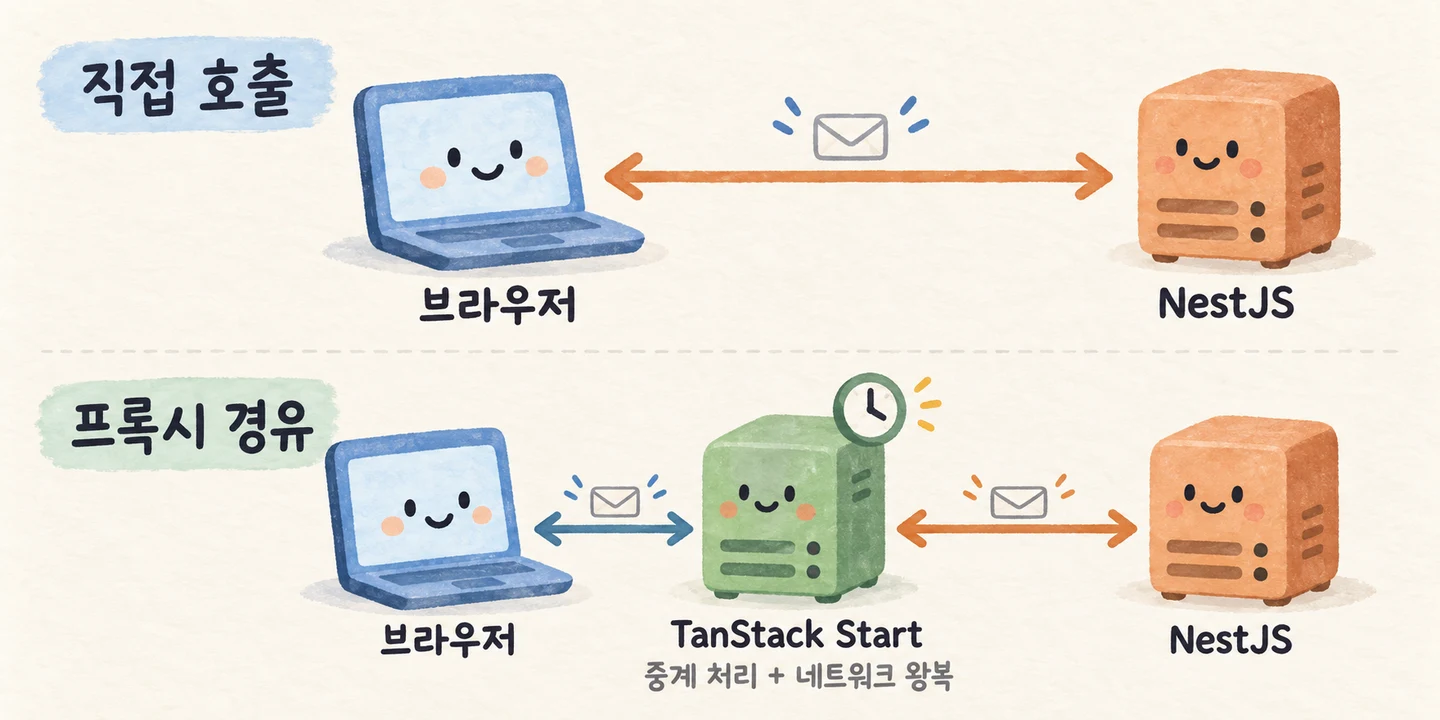
이처럼 프론트엔드에 필요한 요청을 별도 서버에서 처리하고 백엔드와 연결하는 구성을 BFF라고 한다. 모여의 구성도 같은 방향이다. 널리 쓰이는 패턴이라고 중계 비용이 사라지지는 않는다.
게다가 모여에서는 이 한 번이 생각보다 멀다. Worker는 https://api.moyeo.io로 API를 호출하고, 이 요청은 Cloudflare Tunnel을 거쳐 서울 리전의 EC2에 도착한다. 2026년 9월에 한국에서 확인해 보니 moyeo.io는 서울(ICN)이 아니라 미국 SJC, api.moyeo.io는 LAX의 Cloudflare 데이터센터에서 응답했다. Cloudflare에서 Enterprise보다 낮은 요금제의 도메인은 한국 상호접속료 문제로 서울 데이터센터를 쓰지 못하기 때문이다.
결국 한국 사용자의 요청이 태평양을 건너 Worker에 닿고, Worker의 API 호출이 다시 서울 EC2까지 돌아오는 셈이다. Cloudflare가 API 응답을 기다리다 포기하고 523 오류 페이지를 돌려준 적도 있다.
그런데도 이 구성을 고른 건 브라우저의 쿠키를 같은 출처에서 다루고, SSR에서도 같은 세션으로 인증하는 흐름을 하나로 정리하고 싶었기 때문이다. 어차피 SSR로 페이지를 만들 때는 프록시 라우트가 없어도 TanStack Start가 NestJS에서 데이터를 가져와야 한다. 남은 선택은 브라우저의 API 요청까지 같은 중계 경로로 보낼지였다.
경로를 줄일 방법도 있다. Cloudflare Enterprise 요금제, Cloudflare 밖의 서울 진입점, 공개 데이터를 API 왕복 없이 렌더링하는 방식이다. 다만 모두 비용이나 구조를 바꾸는 결정이라, 지금은 흐름을 통일해 두고 서버 간 호출 시간과 NestJS·DB 처리 시간을 나눠 측정하며 이 비용을 확인할 생각이다.
여기서 CORS는 어디에 적용될까?
모여의 브라우저는 웹 페이지와 같은 moyeo.io의 API 경로를 호출한다. 브라우저가 보는 요청은 같은 출처이고, TanStack Start에서 NestJS로 보내는 요청은 서버 간 요청이다. 서버 간 요청에는 브라우저의 CORS 검사가 적용되지 않는다.
브라우저가 api.moyeo.io를 직접 호출한다면 이야기가 달라진다. moyeo.io와 api.moyeo.io는 서로 다른 출처이므로 CORS 설정을 맞춰야 한다. 쿠키를 포함한다면 클라이언트의 전송 옵션과 서버의 허용 출처도 함께 맞춰야 한다. 모여는 기본 호출 경로를 같은 출처 프록시로 맞췄다.
구현 더 보기: 쿠키 중계와 사용자별 SSR 데이터를 섞지 않기
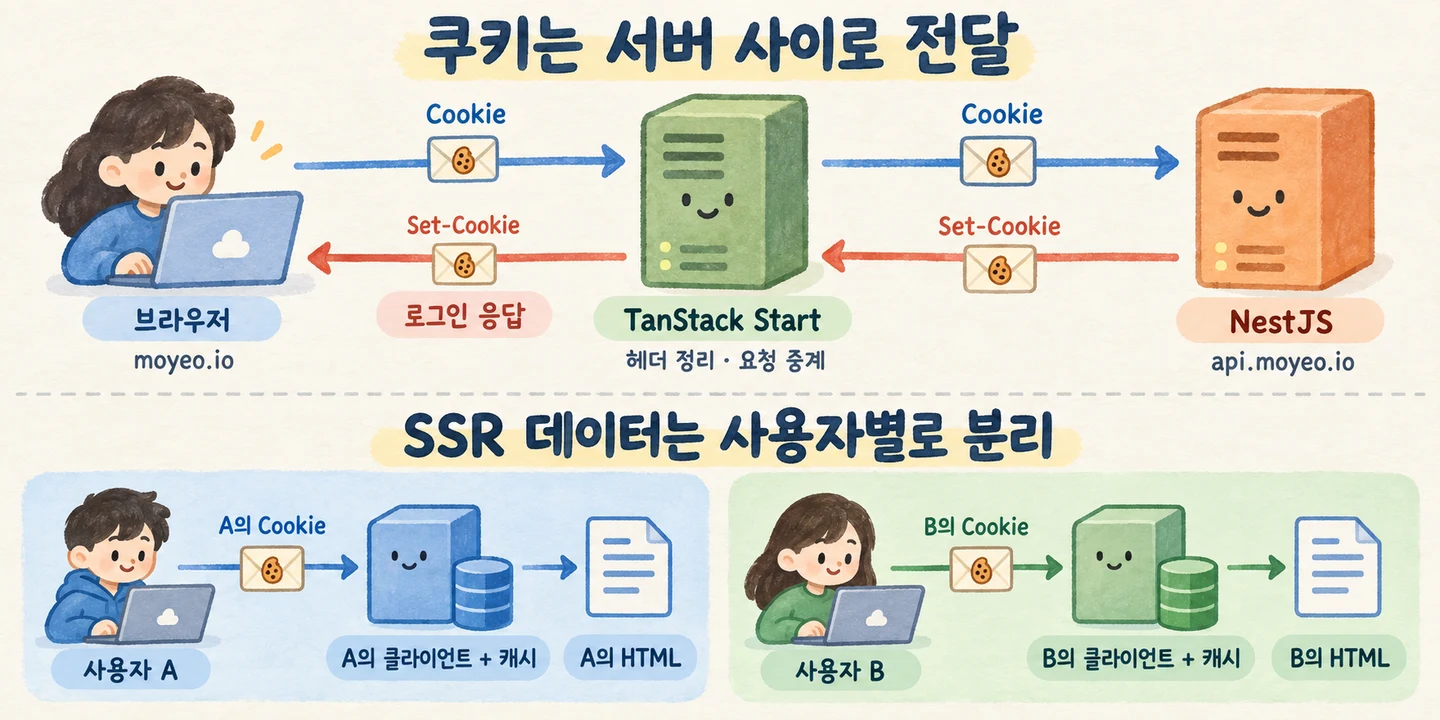
쿠키를 전달할 때는 요청이 가는 길뿐 아니라 응답이 돌아오는 길도 챙겨야 한다. SSR로 페이지를 만들 때는 다른 사용자의 데이터가 섞이지 않는지도 봐야 한다. 아래 그림은 로그인 요청과 응답에서 쿠키가 이동하는 경로, SSR에서 사용자별로 데이터를 나누는 방식을 보여준다.
요청을 넘기기 전에 헤더를 정리한다
TanStack Start는 받은 요청을 그대로 NestJS에 넘기지 않는다. createApiOriginRequest에서 허용된 API 경로인지 확인하고, 다음 서버로 전달하면 안 되는 헤더를 제거한다. Host는 실제 호출할 API 주소에 맞게 바꾸고, 요청이 거쳐 온 주소를 알리는 헤더도 다시 설정한다. 브라우저 요청에 담긴 Origin은 NestJS가 요청의 출처를 검사할 수 있도록 유지한다. SSR에서 만드는 API 요청에도 같은 함수를 사용한다.
이렇게 정리한 요청을 보낼 API 주소는 INTERNAL_API_ORIGIN에 담는다. 이름은 내부 주소처럼 보이지만 운영 값은 공개 주소인 https://api.moyeo.io다. Worker가 AWS 내부망 밖에서 실행되므로, 앞에서 본 것처럼 Cloudflare와 Tunnel을 거쳐 NestJS를 호출한다.
로그인 응답과 SSR 조회는 역할이 다르다
로그인 응답은 브라우저에 새 쿠키를 저장시키는 과정이다. NestJS가 쿠키를 여러 개 보내면 TanStack Start도 Set-Cookie 헤더를 각각 전달한다. 쿠키의 만료일인 Expires에도 쉼표가 들어가므로, 여러 쿠키를 쉼표로 이어 붙이면 어디까지가 하나의 쿠키인지 잘못 해석될 수 있다.
예를 들어 쿠키 두 개를 보내는 응답은 다음과 같다. 첫 번째 줄의 Wed, 뒤에 있는 쉼표는 쿠키를 구분하는 문자가 아니라 날짜의 일부다.
Set-Cookie: session=example; Expires=Wed, 21 Oct 2026 07:28:00 GMT; Path=/; Secure; HttpOnly
Set-Cookie: device=example; Path=/; Secure; HttpOnlyhttp이를 하나의 문자열로 합친 뒤 쉼표로 나누면 어떻게 될까? 쿠키는 두 개인데, 날짜까지 잘려 세 조각이 된다.
const cookies = [
  "session=example; Expires=Wed, 21 Oct 2026 07:28:00 GMT",
  "device=example",
];

const merged = cookies.join(", ");
const pieces = merged.split(",");

console.log(pieces);
// [
//   "session=example; Expires=Wed",
//   " 21 Oct 2026 07:28:00 GMT",
//   " device=example"
// ]ts그래서 앞의 중계 코드에서는 getSetCookie()로 쿠키를 각각 읽고, append()로 헤더를 하나씩 추가했다. 합친 문자열에서 쿠키의 경계를 다시 찾을 필요가 없다. 또 중계한 응답에는 인증 응답인지와 관계없이 모두 Cache-Control: no-store를 설정해, 사용자별 응답이 캐시에 남지 않게 한다.
SSR 조회는 이미 로그인한 사용자의 데이터를 가져와 HTML을 만드는 과정이다. 페이지 요청의 Cookie는 NestJS에 보내지만, NestJS가 응답에 넣은 Set-Cookie를 페이지 응답에 자동으로 옮겨 주지는 않는다. API에 쿠키를 보내는 처리와 브라우저에 새 쿠키를 돌려주는 처리는 별개다. 모여에서도 로그인 응답 중계와 SSR 데이터 조회를 각각 구현했다.
A의 데이터가 B의 페이지에 들어가면 안 된다
SSR 서버는 여러 사용자의 요청을 동시에 처리한다. 이때 사용자 정보가 들어 있는 클라이언트나 캐시를 하나로 공유하면, A의 쿠키로 요청하거나 A의 데이터를 B의 페이지에 넣을 위험이 있다.
그래서 모여는 SSR 요청마다 API 클라이언트와 데이터 캐시인 QueryClient를 새로 만든다. A와 B가 동시에 새로고침해도 각자의 쿠키로 데이터를 조회하고, 각자의 캐시에 저장한다. 브라우저 안에서는 클라이언트를 재사용하되, SSR 서버에서는 여러 사용자가 이런 객체를 공유하지 않게 했다. 두 요청을 동시에 처리하는 테스트로 쿠키와 캐시가 섞이지 않는지도 확인한다.
코드로 옮기면 다음과 같다. 앞서 본 createServerApiClient도 이 안에서 함께 호출해, 각 요청의 쿠키를 읽게 한다.
import { QueryClient } from "@tanstack/react-query";

function createSsrContext(request: Request, apiOrigin: string) {
  const api = createServerApiClient(request, apiOrigin);
  const queryClient = new QueryClient();

  return { api, queryClient };
}tsA의 요청과 B의 요청에서 이 함수를 각각 호출하면 서로 다른 객체가 만들어진다. SSR 서버 전체에서 쓸 QueryClient 하나를 함수 밖에 만들어 두고 공유하는 것과는 다르다.
브라우저가 API를 직접 호출한다면?
앞에서 말했듯 브라우저가 api.moyeo.io를 직접 호출하는 구성이라면 CORS 설정을 맞춰야 한다. 이때 사용자 정의 헤더 등을 보내면 브라우저는 실제 요청에 앞서 OPTIONS 요청으로 서버가 해당 요청을 허용하는지 먼저 확인할 수 있다. 이것이 preflight이며, 이 사전 확인 요청에는 쿠키를 보내지 않는다.
쿠키를 포함하는 실제 요청을 허용하려면, API 서버는 허용할 출처를 구체적으로 지정해야 한다. 모든 출처를 뜻하는 *로 처리할 수는 없다. 브라우저에 credentials: "include"를 설정해도 쿠키의 호스트와 SameSite 조건은 그대로 적용된다. 이 차이는 앞서 작성한 CORS 글에서 더 자세히 정리했다.
쿠키가 있다고 모든 요청을 믿을 수는 없다
브라우저가 쿠키를 자동으로 보내면 로그인 상태를 유지하기는 편하지만, 이를 이용한 공격도 가능해진다. 사용자가 로그인한 브라우저에서 외부 사이트를 열었는데, 그 사이트가 사용자가 의도하지 않은 변경 요청을 보내게 한다면 어떨까? 서버가 쿠키만 확인하면 사용자의 정상 요청으로 오해할 수 있다. 이것이 CSRF가 노리는 상황이다.
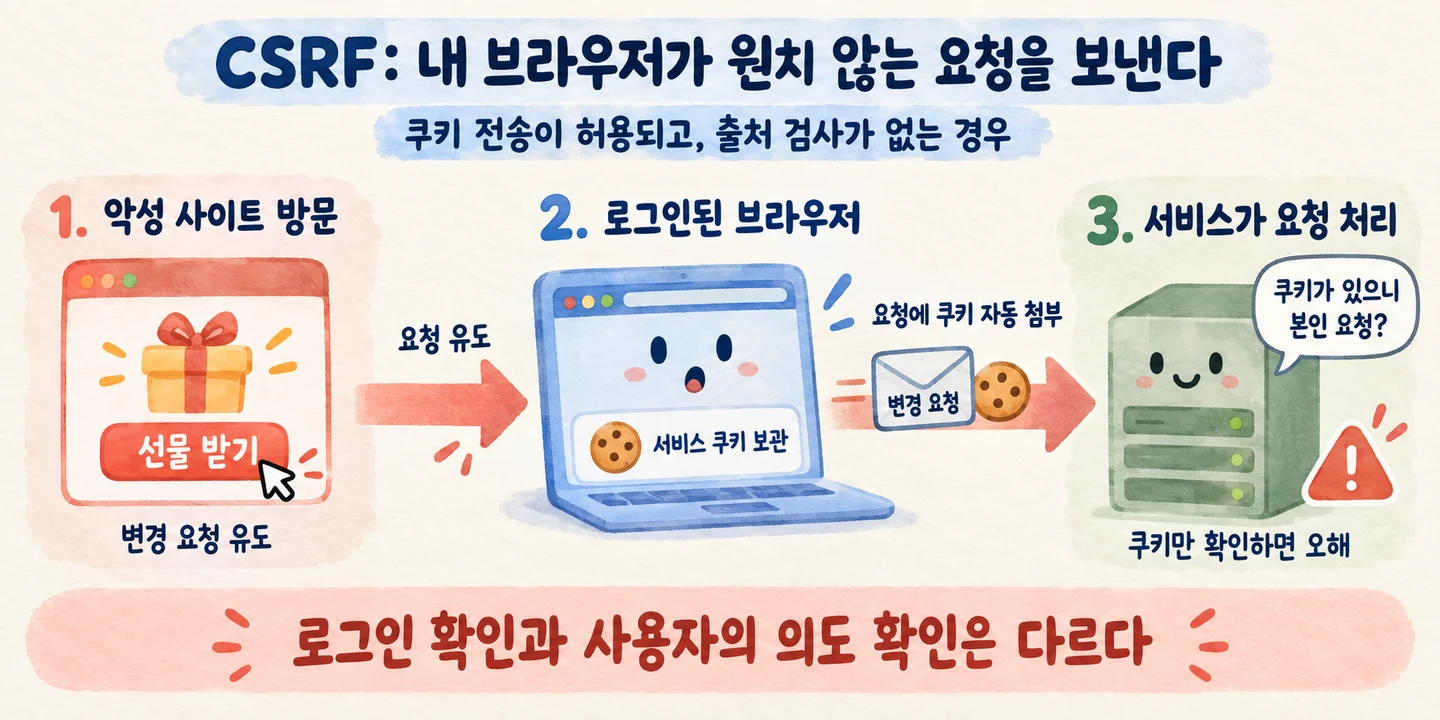
앞에서 본 CORS와도 다르다. CORS는 다른 출처의 응답을 브라우저의 코드가 읽을 수 있는지 다룬다. 서버가 요청을 처리해도 되는지 판단하는 인증과 권한 검사를 대신하지 않는다.
변경 요청에서는 요청의 출처도 확인한다. 모여는 Origin으로 어느 출처에서 시작된 요청인지 확인한다. 모여 클라이언트가 넣는 표시 헤더도 검사하고, 브라우저가 다른 사이트에서 시작한 요청이라고 알렸다면 거부한다. 쿠키로 사용자를 확인하는 것과 별도로 검사하는 조건이다.
허용한 출처에서 왔다는 사실만으로 사용자가 누구인지 알 수 없고, 유효한 세션이 있다는 사실만으로 의도한 변경 요청인지 알 수 없다. 앞에서 설정한 SameSite 쿠키도 이 검사와 겹쳐 쓰는 방어다.
구현 더 보기: 변경 요청의 출처 검사
아래는 실제 정책 함수를 읽기 쉽게 정리한 예시다. 이 검사는 데이터를 바꾸는 요청을 대상으로 한다. GET·HEAD·OPTIONS는 제외하고, 그 외 메서드에서는 요청의 출처와 표시 헤더를 확인한다. 제외된 메서드도 로그인과 작업 권한은 그대로 검사한다.
if (SAFE_METHODS.has(method)) {
  return true;
}
if (origin === undefined || !allowedOrigins.has(origin)) {
  return false;
}
if (fetchSite === "cross-site") {
  return false;
}
if (clientHeader !== TRUSTED_CLIENT_HEADER_VALUE) {
  return false;
}
return true;ts클라이언트 표시 헤더는 “모여 클라이언트가 보내는 요청”이라는 표시로 사용하는 공개된 고정값이다. 비밀 키나 로그인 토큰은 아니다. 다른 사이트의 브라우저 코드가 이 헤더를 붙여 요청하려면 CORS 검사도 통과해야 하므로, 서버의 Origin 검사와 함께 사용한다.
브라우저 밖에서 요청을 만드는 프로그램은 이 헤더를 직접 넣을 수 있다. 따라서 표시 헤더가 있다고 정상 사용자라고 믿지는 않는다. 실제 사용자와 작업 권한은 세션을 확인한 뒤 별도로 판단한다.
여섯 번째 기기에서 로그인하면 어떻게 될까?
사용자가 노트북에 이어 휴대전화에서도 로그인하면 또 하나의 세션이 생긴다. 모여는 한 계정에서 동시에 활성 상태인 세션을 5개까지 허용한다.
이 제한은 기기 자체가 아니라 활성 세션의 수를 기준으로 한다. 같은 노트북에서도 Chrome과 Safari를 쓰면 서로 다른 세션이 될 수 있다. 사람 수를 정확히 판별하는 기능은 아니지만, 계정 하나를 무제한으로 함께 쓰는 것을 어렵게 만드는 정책이다.
5개가 찬 뒤 새 기기에서 로그인하면 어떻게 할까? 모여는 새 로그인을 허용하고, 최근 사용 기록이 가장 오래된 기존 세션을 종료한다. 새 기기에서 로그인할 때마다 예전 기기를 찾아 로그아웃해야 하는 불편을 줄이고 싶었다.
아래 예시는 노트북 Chrome을 다시 사용한 뒤 새 기기로 로그인하는 상황을 보여준다. 최근 사용 기록이 갱신되면서 어떤 세션이 교체 대상으로 남는지 확인할 수 있다.
휴대전화 Safari 세션은 종료되고 새 PC가 로그인된다.
새 로그인 성공 · 활성 세션 5개 유지전체 과정을 글로 보기
- 다섯 세션이 로그인돼 있다
첫 로그인은 노트북 Chrome이었다. 최근 기록도 아직 가장 오래됐다.
- 노트북 Chrome을 다시 사용한다
20분 뒤 사용해 최근 기록이 12:20으로 갱신된다.
- 새 PC에서 로그인한다
새 세션을 만들기 전, 기존 세션의 최근 사용 기록을 비교한다.
- 오래된 세션을 끝내고 새 로그인을 허용한다
휴대전화 Safari 세션은 종료되고 새 PC가 로그인된다.
노트북 Chrome을 최근에 사용했다면 그 세션을 남기고, 그다음으로 사용 기록이 오래된 세션을 끝낸다. 무조건 로그인한 순서대로 밀어내는 방식은 아니다. 결과적으로 새 로그인은 성공하고 활성 세션은 5개를 유지한다.
교체 정책을 간단히 표현하면 다음과 같다. 여기서 activeSessions는 사용할 수 있는 기존 세션들이고, 새 세션을 추가하기 전에 교체 대상을 고른다.
const maximumSessions = 5;
const replaceCount = activeSessions.length - maximumSessions + 1;
const sessionsToReplace = [];

if (replaceCount > 0) {
  const oldestFirst = activeSessions.toSorted((left, right) => {
    return left.lastSeenAt.getTime() - right.lastSeenAt.getTime();
  });

  for (const session of oldestFirst.slice(0, replaceCount)) {
    sessionsToReplace.push(session.id);
  }
}ts새 기기 로그인은 이메일로 알려 준다
낯선 기기에서 로그인했을 때 사용자가 알아차릴 수 있어야 한다. 그렇다고 같은 브라우저로 로그인할 때마다 메일을 보내면 금방 무시하게 된다. 그래서 세션 쿠키와 별도로 기기 인식 쿠키를 두었다. 전에 본 브라우저인지 판단하는 용도이며, 기기 인식 쿠키만으로 로그인할 수는 없다.
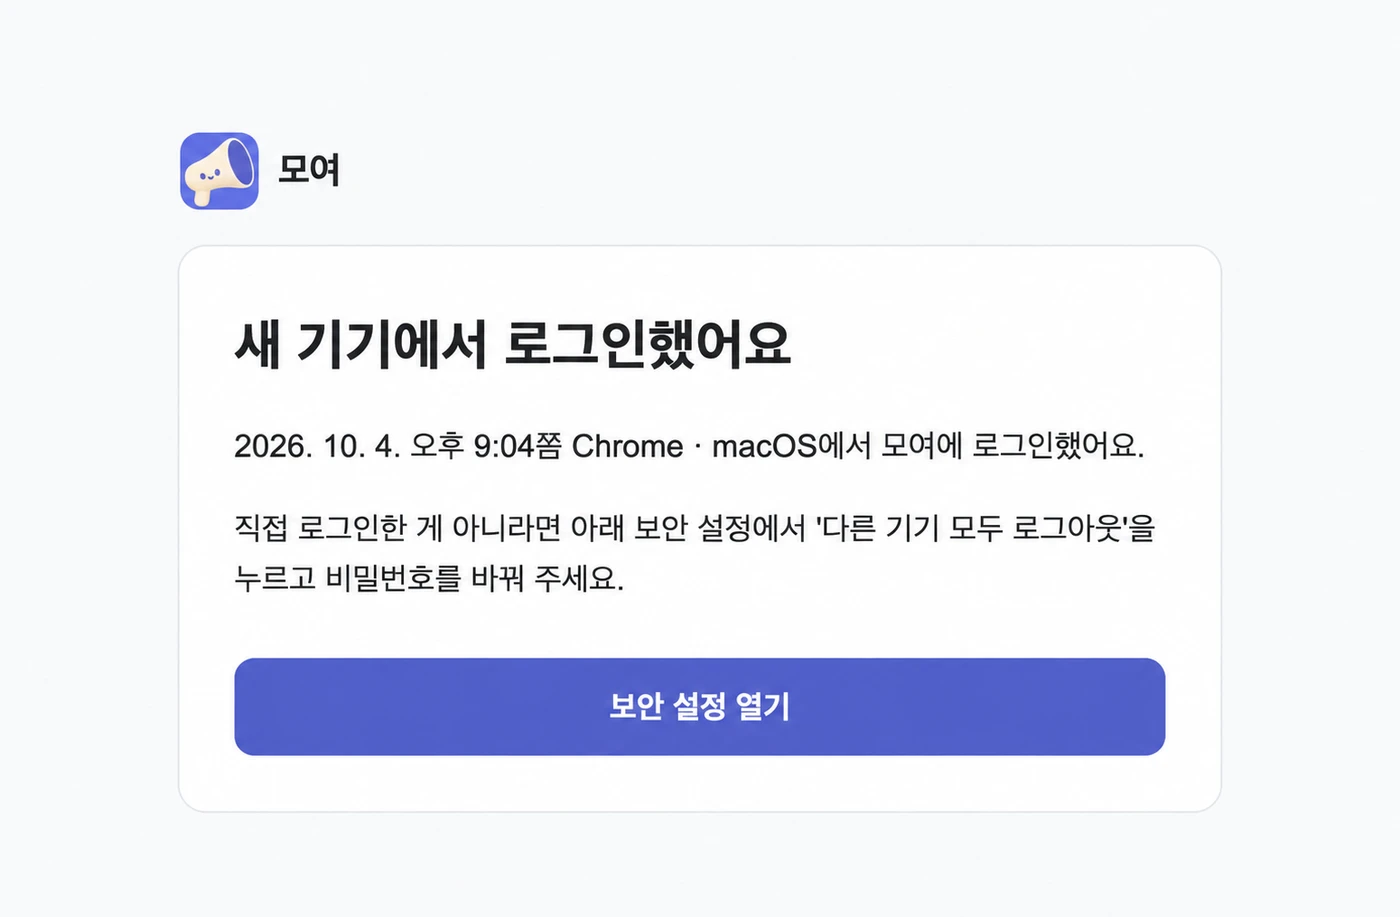
이전에 로그인한 기록이 있는 사용자에게 새 기기 로그인이 확인되면, 서버는 발송 조건을 확인한 뒤 안내 메일을 보낸다. 메일에는 로그인 시각과 브라우저·운영체제를 적고, 본인이 아니라면 보안 설정에서 다른 기기를 로그아웃시키고 비밀번호를 바꾸도록 안내한다. 화면 예시는 실제 안내를 바탕으로 개인정보 영역을 제외해 정리했다.
구현 더 보기: 팀 권한, 동시 로그인과 새 기기 알림
팀 기능을 쓸 권한과 계정 공유는 다른 문제다
팀 기능을 허용할 때는 요금제만 확인하지 않는다. 사용자의 역할과 작업하려는 리소스도 함께 확인한다. 이런 속성 기반 판단이 ABAC이다. 다만 권한을 잘 나눠도 모든 팀원이 계정 하나를 공유하면 서버는 같은 사용자로 보게 된다. 그래서 팀 권한과 계정 공유 정책을 함께 고민했다.
최근 사용 기록은 요청마다 저장하지 않는다
교체할 세션은 DB에 기록된 최근 사용 시각인 lastSeenAt으로 고른다. 값이 같으면 발급 시각을 비교하고, 그 값도 같으면 ID로 순서를 정한다.
사용자가 요청할 때마다 사용 시각을 저장하면 DB에 쓰는 작업도 계속 늘어난다. 그래서 마지막 갱신 이후 최소 15분이 지났을 때 다시 기록한다. 교체 대상을 고를 때도 모든 요청의 정확한 시각이 아니라, DB에 남아 있는 최근 기록을 기준으로 삼는다.
갱신 여부를 판단하는 조건만 남기면 다음과 같다. 두 시각의 차이를 구하고, 15분 이상 지났는지 확인한다.
function shouldUpdateLastSeen(lastSeenAt: Date, now: Date) {
  const minimumInterval = 15 * 60 * 1_000;
  const elapsed = now.getTime() - lastSeenAt.getTime();

  return elapsed >= minimumInterval;
}ts10시에 기록했다면 10시 1분 요청에서는 다시 쓰지 않고, 10시 15분 이후에 요청이 들어왔을 때 갱신한다. 따로 도는 예약 작업 없이 요청이 들어올 때 판단한다. 기록을 갱신하지 않는 요청에서도 세션이 유효한지는 확인한다.
동시에 로그인하면 둘 다 마지막 한 자리를 차지할 수 있다
활성 세션이 4개인 계정에 로그인 두 건이 동시에 들어왔다고 해 보자. 두 요청이 각각 세션 수를 확인하면 둘 다 “하나 더 만들어도 된다”고 판단할 수 있다. 이후 세션을 하나씩 만들면 활성 세션이 6개가 된다. 확인할 때는 맞았던 조건이 다른 요청의 처리 때문에 바뀌는 문제가 경쟁 조건이다.
모여는 DB에서 해당 계정의 사용자 행을 잠가 같은 계정의 로그인 처리가 순서대로 진행되게 했다. 첫 요청이 5번째 세션을 만들면, 다음 요청은 5개가 된 상태를 확인한다. 그리고 오래된 세션 하나를 끝낸 뒤 새 세션을 만든다. 잠그는 범위는 해당 계정 하나라서, 다른 계정의 로그인은 기다리지 않는다. 아래 그림은 두 처리 방식의 차이를 보여준다.
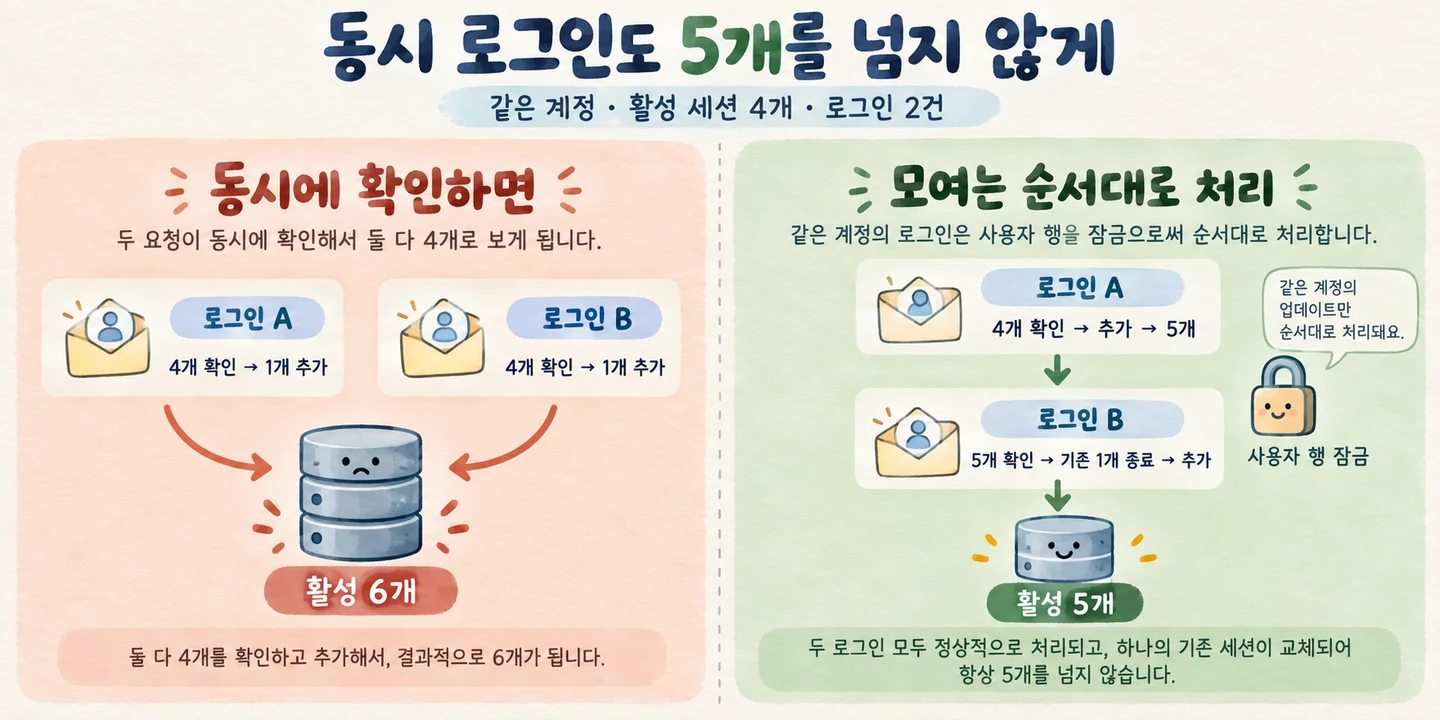
코드에서는 기존 세션 종료와 새 세션 생성, 알림 기록을 하나의 트랜잭션으로 묶었다. 트랜잭션은 여러 DB 변경을 모두 반영하거나, 중간에 실패하면 함께 되돌리는 처리 단위다. 기존 세션만 종료되고 새 로그인은 저장되지 않는 상황을 피하기 위한 것이다.
await database.transaction(async (transaction) => {
  await lockUser(transaction, userId);

  const sessions = await lockActiveSessions(transaction, userId);
  const replacedIds = selectSessionsToReplace({
    activeSessions: sessions,
    maximumActiveSessionCount: 5,
  });

  await revokeSessions(transaction, replacedIds);
  await insertSession(transaction, newSession);
  await recordDeviceNotice(transaction, newSession);
});ts실제로는 잠근 뒤 계정이 이용 가능한 상태인지도 다시 확인한다. 통합 테스트에서도 로그인 기록이 없는 계정에 요청 7개를 동시에 보내는 경우를 확인했다. 로그인 7건은 성공하고, 세션 2개가 종료돼 활성 세션은 5개가 남는다.
로그인은 먼저 끝내고, 안내 메일은 따로 보낸다
기기 인식 쿠키인 __Host-moyeo-device는 180일 동안 보관한다. 새 계정의 첫 로그인이나 이미 알고 있는 기기에는 새 기기 안내를 보내지 않는다. 기기 인식 정보가 없는 경우도 이 알림 정책에서 제외한다. 메일을 받을 이메일과 언어 정보가 있는지도 확인한다.
메일 서버가 느리다고 로그인까지 기다리게 하고 싶지는 않았다. 그래서 로그인할 때는 세션과 함께 “이 메일을 보내야 한다”는 기록만 DB에 남긴다. 메일 발송은 별도 작업이 맡고, 같은 사용자와 기기에 대한 중복 발송이나 재시도, 전달 결과도 관리한다.
문제가 생겼을 때 로그인을 끝낼 수 있어야 한다
새 기기 로그인 메일을 받은 사용자가 “이건 내가 아닌데?”라고 생각했다면, 직접 다른 기기의 로그인을 끝낼 수 있어야 한다. 모여의 보안 설정에서는 다른 기기를 로그아웃시킬 수 있다. 운영자에게도 사용자 문의나 악성 이용에 대응할 수단이 필요해, 모든 기기 로그아웃과 이용 제한 기능을 따로 만들었다.
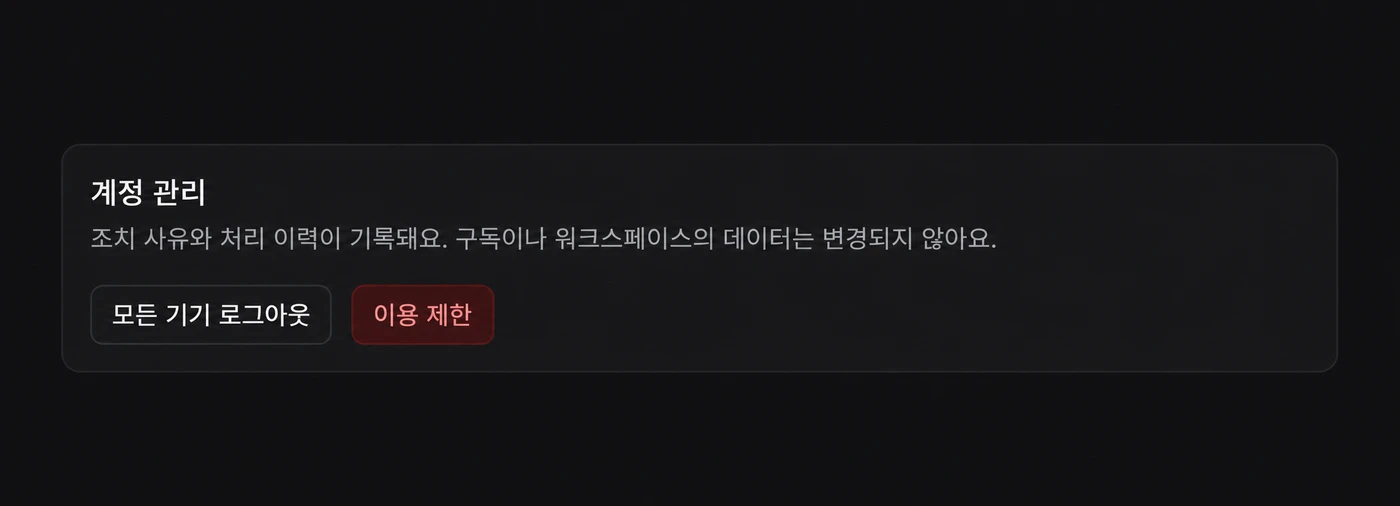
화면은 실제 계정 관리 영역을 바탕으로 정리한 예시다. 로그아웃 버튼은 서버에 저장된 세션을 종료한다. 브라우저의 쿠키는 그대로 남는다. 브라우저가 다음 요청을 보내면 서버는 해당 세션이 종료됐음을 확인하고 인증을 거부한다.
아래 도식은 운영자가 세션을 종료한 뒤, 브라우저에 남아 있는 쿠키로 보낸 요청이 서버에서 거부되는 과정을 보여준다.
클라이언트가 세션 종료 응답을 받고 로그인 화면으로 안내한다.
쿠키가 남았다는 사실만으로 인증할 수 없다전체 과정을 글로 보기
- 사용자는 로그인돼 있다
브라우저에 쿠키가 있고 서버의 세션도 유효하다.
- 운영자가 모든 기기 로그아웃을 실행한다
권한을 확인한 뒤 DB의 대상 세션들을 종료한다.
- 기존 쿠키로 다음 요청이 온다
브라우저는 쿠키를 보내지만, 서버는 종료된 기록을 확인한다.
- 다음 인증 요청을 거부한다
클라이언트가 세션 종료 응답을 받고 로그인 화면으로 안내한다.
클라이언트는 세션이 종료됐다는 응답을 받으면 사용자를 로그인 화면으로 안내한다. 운영자가 버튼을 누르는 순간 모든 브라우저가 닫히거나 이미 실행 중인 작업이 취소되는 것은 아니다.
모든 기기 로그아웃만 했다면 다시 로그인할 수 있다. 재로그인까지 막아야 할 때는 계정 이용 제한을 따로 적용한다.
비밀번호를 바꿀 때는 어느 기기를 남길까?
사용자가 현재 비밀번호를 확인하고 바꾸는 경우에는 지금 사용 중인 세션을 유지하고 다른 세션을 끝낸다. 비밀번호를 잊어 재설정 링크로 바꾸는 경우에는 모든 세션을 끝낸다.
| 조치 | 지금 사용 중인 기기 | 다른 기기 |
|---|---|---|
| 다른 기기 모두 로그아웃 | 유지 | 다시 로그인 필요 |
| 현재 비밀번호를 확인하고 변경 | 유지 | 다시 로그인 필요 |
| 재설정 링크로 비밀번호 변경 | 다시 로그인 필요 | 다시 로그인 필요 |
| 운영자의 모든 기기 로그아웃 | 다시 로그인 필요 | 다시 로그인 필요 |
로그인 유지와 본인 재확인은 다른 시간이다
로그인 상태를 오래 유지하더라도 민감한 작업에는 본인 확인을 다시 요구할 수 있다. 모여는 이 시간을 구분했다.
| 기준 | 기본값 | 사용자에게 일어나는 일 |
|---|---|---|
| 세션의 최대 수명 | 발급 후 30일 | 계속 사용했어도 다시 로그인 |
| 사용하지 않은 기간 | 7일 | 최근 사용 기록이 갱신되지 않으면 다시 로그인 |
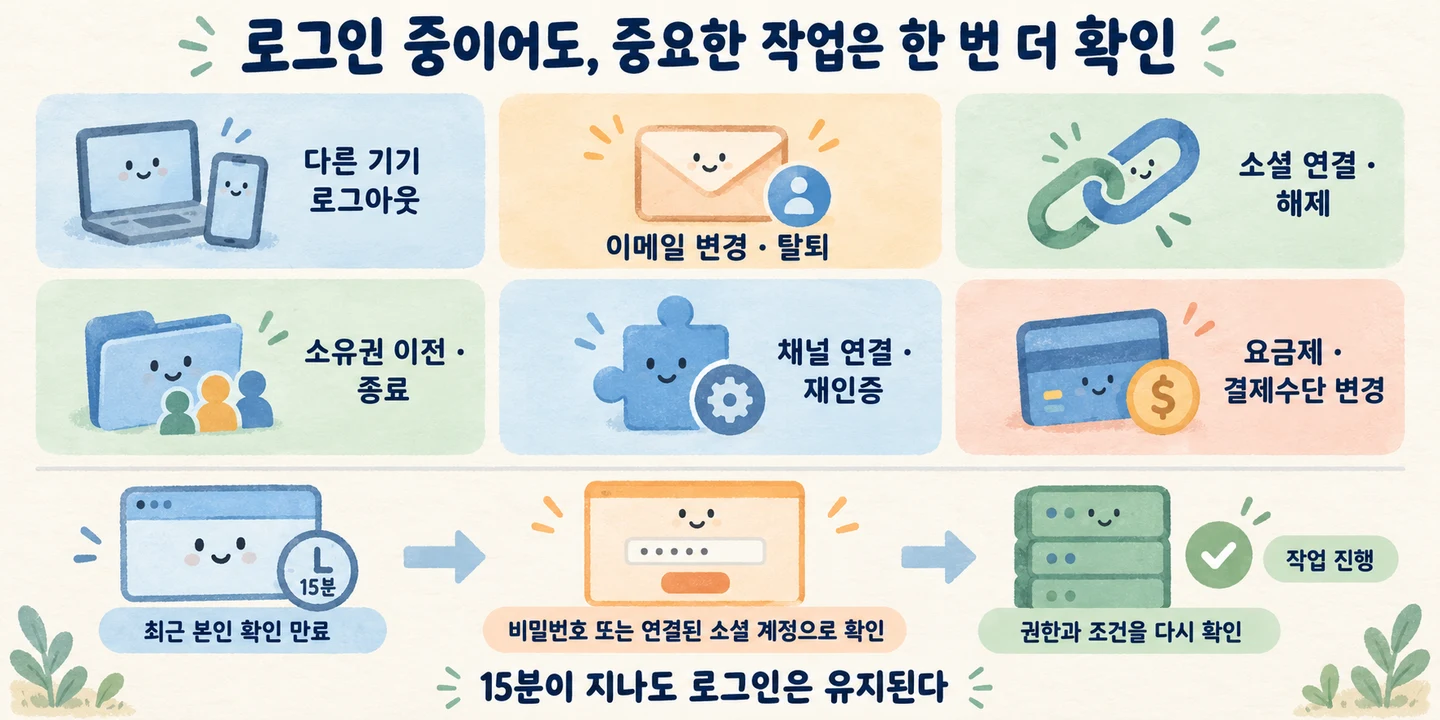
| 최근 본인 확인 | 15분 | 다른 기기 로그아웃·이메일 변경 등 중요한 작업 전에 다시 확인 |
15분이 지나도 로그인은 그대로 유지된다. 페이지를 읽는 것과 계정·결제 설정을 바꾸는 것은 영향이 다르므로, 중요한 작업을 실행할 때 최근에 본인 확인을 했는지 다시 검사한다. 누군가 열려 있는 브라우저를 잠깐 사용하더라도 중요한 조치를 그대로 실행하지 못하게 하려는 구분이다.
모여에서 실제로 최근 본인 확인을 요구하는 작업은 다음과 같다. 같은 작업이라도 최근 확인이 아직 유효하면 매번 확인 창을 띄우지는 않는다.
| 영역 | 최근 본인 확인을 요구하는 작업 |
|---|---|
| 세션 관리 | 다른 기기 모두 로그아웃 |
| 계정 | 이메일 변경 요청, 회원 탈퇴 요청 |
| 로그인 수단 | 비밀번호 로그인 등록, 소셜 계정 연결·해제 |
| 워크스페이스 | 소유권 이전, 워크스페이스 종료 |
| 채널 | 새 채널 연결, 기존 채널 재인증 |
| 결제 | 요금제 변경, 구독 해지·즉시 해지, 결제수단 등록, 쿠폰 사용 |
| 운영자 조치 | 사용자 세션 종료·이용 제한·제한 해제·플랫폼 역할 변경, 쿠폰 관리·환불 처리·공지 변경 등 |
아래 그림은 이런 작업의 예시와 본인 확인 이후 처리 흐름을 보여준다. 확인에는 계정에서 사용할 수 있는 비밀번호나 연결된 소셜 계정을 사용한다. 본인 확인을 마쳤더라도 서버는 작업 권한과 실행 조건을 다시 검사한다.
비밀번호 변경은 앞의 표와 처리 방식이 조금 다르다. 최근 본인 확인이 유효한지만 보고 허용하지 않고, 사용자가 입력한 현재 비밀번호를 직접 검증한다. 변경에 성공하면 현재 세션의 본인 확인 유효기간도 갱신한다.
구현 더 보기: 운영자 권한과 로그아웃 이후 정리
버튼이 보인다고 조치를 허용하지 않는다
운영자 버튼을 숨기는 것만으로는 권한을 보호할 수 없다. 모여는 서버에서 요청한 사람이 해당 조치를 할 수 있는지 확인한다. DB에서 대상을 잠근 뒤에도 운영자의 권한과 계정 상태를 다시 확인한다. 처음 확인한 뒤 실제로 변경하기 전까지 상태가 바뀔 수 있기 때문이다.
조치를 제한한 보호 대상인지, 앞서 읽은 정보가 다른 변경으로 오래된 상태가 되지는 않았는지도 검사한다. 조치를 실행하면 사유와 처리 이력을 남겨 나중에 누가 무엇을 했는지 확인할 수 있게 한다.
민감한 요청은 본인 확인 뒤 다시 처리한다
예를 들어 다른 기기 로그아웃 요청에서 최근 본인 확인이 만료됐다면, 서버는 바로 세션을 종료하지 않고 추가 확인이 필요하다는 응답을 보낸다. 로그인은 유효해도 본인 확인 시간이 지났다면 기다리게 하는 것이다. 서버 코드로 보면 조건 하나다.
if (principal.freshAuthenticationExpiresAt <= now) {
  return { status: "fresh_authentication_required" };
}

return repository.revokeOthers({
  userId: principal.userId,
  currentSessionId: principal.sessionId,
  revokedAt: now,
  reason: SessionRevocationReason.revokedOtherSessions(),
});ts브라우저는 이 응답을 받아 확인 화면을 띄운다. 비밀번호 확인처럼 현재 화면에서 인증을 마치면 원래 요청을 한 번만 다시 보내고, 취소했다면 작업을 진행하지 않는다. 소셜 계정으로 확인하는 경우에는 외부 로그인 화면을 거쳐 돌아오므로, 원래 작업 화면에서 다시 진행하도록 안내한다.
이 흐름은 oRPC 클라이언트의 인터셉터 하나가 맡는다. 확인 창을 띄우는 브라우저 처리라서 SSR에서는 함께 쓰지 않는다.
const freshAuthenticationInterceptor = async ({ next }) => {
  try {
    return await next();
  } catch (error) {
    // 본인 확인이 필요하다는 오류가 아니면 그대로 넘긴다
    if (!isApiError(error, "FRESH_AUTHENTICATION_REQUIRED")) {
      throw error;
    }

    // 확인 창을 띄우고 사용자의 선택을 기다린다
    const result = await requests.request();
    if (result === "canceled") {
      throw new FreshAuthenticationCanceledError();
    }

    // try 밖에서 다시 보내므로, 또 실패하면 재시도 없이 오류로 끝난다
    return await next();
  }
};ts다시 보낸 요청이라고 그대로 통과시키지는 않는다. 서버는 실제 변경 시점에 본인 확인 상태와 작업 조건을 다시 검사한다.
비밀번호 재설정 링크도 여러 번 쓸 수 없게 했다. 토큰이 재설정용인지, 이미 사용됐는지, 발급 후 비밀번호가 바뀌지는 않았는지 확인한다. 토큰을 사용 처리하는 작업과 비밀번호 변경, 모든 세션 종료를 같은 트랜잭션으로 묶는다.
로그아웃 뒤에는 캐시와 알림 연결도 정리한다
세션을 종료할 때는 그 세션에 연결된 브라우저 푸시 알림 구독인 WebPush도 같은 트랜잭션에서 정리한다. 클라이언트가 세션 종료 응답을 받으면 사용자 데이터를 담은 QueryClient 캐시를 비우고 로그인 화면으로 안내한다. 같은 브라우저에서 다른 계정으로 로그인했을 때 이전 계정의 데이터가 남아 보이지 않게 하기 위해서다.
탭을 여러 개 열어 둔 경우도 챙겼다. 한 탭에서 로그아웃하면 쿠키는 브라우저 전체에서 사라지지만, 다른 탭 화면에는 로그인한 상태의 데이터가 그대로 남는다. 그래서 로그아웃한 탭은 BroadcastChannel로 다른 탭에 알리고, 로그인한 화면을 보던 탭만 같은 정리를 따라 한다. 이 알림은 useSignedOutBroadcast가 주고받는다.
한 탭 안에서도 비슷한 일이 생긴다. 화면 데이터를 가져오는 Query 캐시와 실시간 변경을 받는 SSE 연결이 같은 순간에 세션 만료 오류를 받으면, 캐시 정리와 로그인 화면 이동이 두 번 일어날 수 있다. 그래서 createSessionRecovery는 진행 중인 복구가 있으면 같은 Promise를 돌려줘, 재검증과 이동을 한 번만 실행한다.
function createSessionRecovery(run) {
  let pending;

  return {
    recover: (failure) => {
      // 이미 복구 중이면 새로 시작하지 않고 같은 Promise를 기다린다
      pending ??= Promise.resolve(run(failure)).finally(() => {
        pending = undefined;
      });

      return pending;
    },
  };
}ts서버가 늘어나면 JWT가 더 나을까?
여기까지 보면 모여의 인증은 서버의 로그인 기록을 자주 확인한다. 그러면 “서버가 늘어나면 세션을 관리하기 어렵지 않을까? JWT를 쓰는 게 낫지 않을까?”라는 질문이 생긴다.
먼저 서버 한 대의 CPU와 메모리를 키우는 것이 Scale Up, 서버 개수를 늘려 요청을 나누는 것이 Scale Out이다. 세션을 여러 서버가 어떻게 공유할지는 주로 Scale Out에서 고민하게 된다.
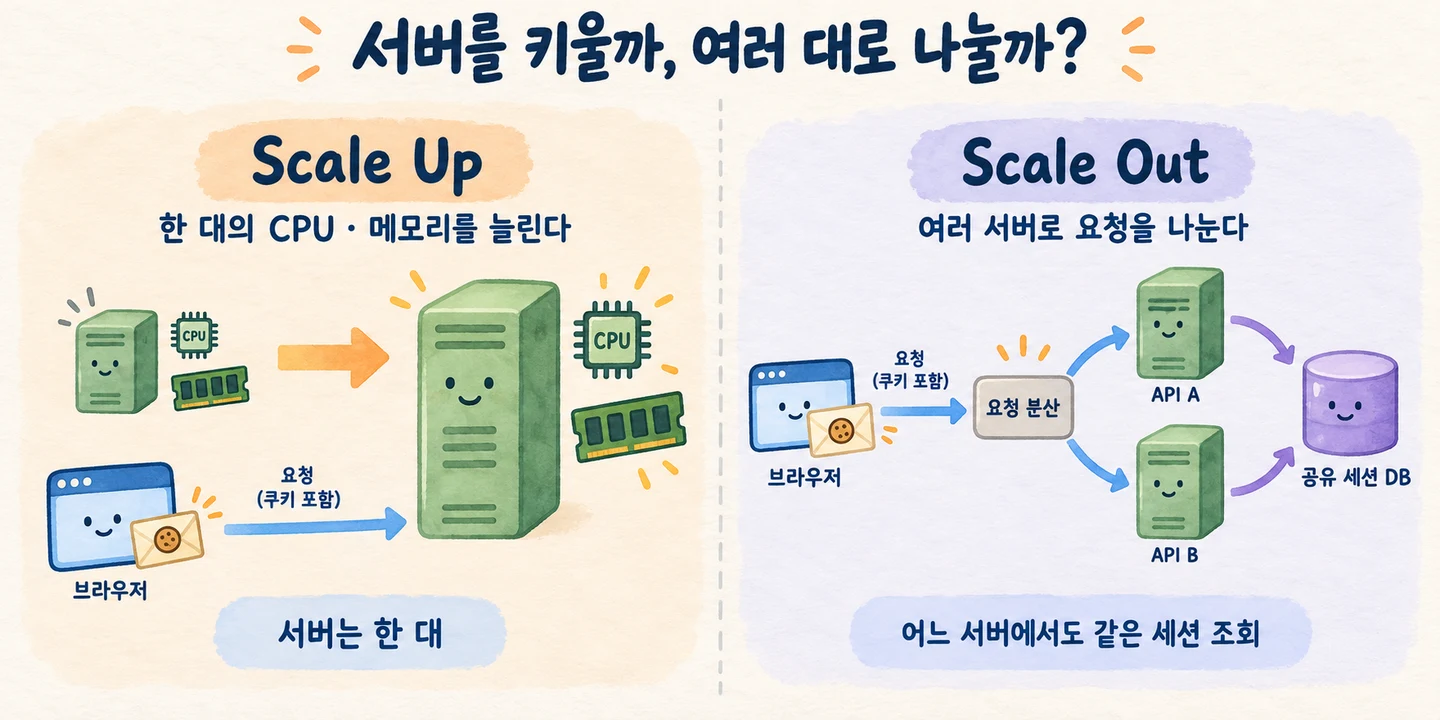
2026년 10월 기준 모여의 API는 EC2 한 대에서 실행되고, 세션은 API 서버의 메모리가 아니라 PostgreSQL에 저장한다. 그래서 나중에 API 서버를 A와 B로 나눠도, 그림 오른쪽처럼 같은 DB를 조회해 같은 로그인 기록을 확인할 수 있다. A에서 로그인한 사용자의 다음 요청을 꼭 A로 보내지 않아도 된다.
JWT는 토큰 안에 사용자 ID나 만료 시각 같은 정보를 담고, 서명을 붙인다. 서버는 서명으로 토큰이 위조되거나 바뀌지 않았는지 확인하고, 발급자·사용 대상·만료 시각 등도 검사한다. 토큰 자체만 검증해 인증하는 구성이라면 요청마다 중앙 세션 저장소를 조회하지 않아도 된다. 그래서 여러 서비스가 같은 토큰을 받아 검증해야 할 때 유용하다.
아래 그림은 두 방식에서 서버가 무엇을 확인하는지 비교한다. 두 토큰 모두 쿠키로 전달할 수 있다. 차이는 쿠키를 사용하는지보다, 현재 로그인 상태를 DB에서 확인하는지, 토큰에 담긴 정보를 검증하는지에 있다.
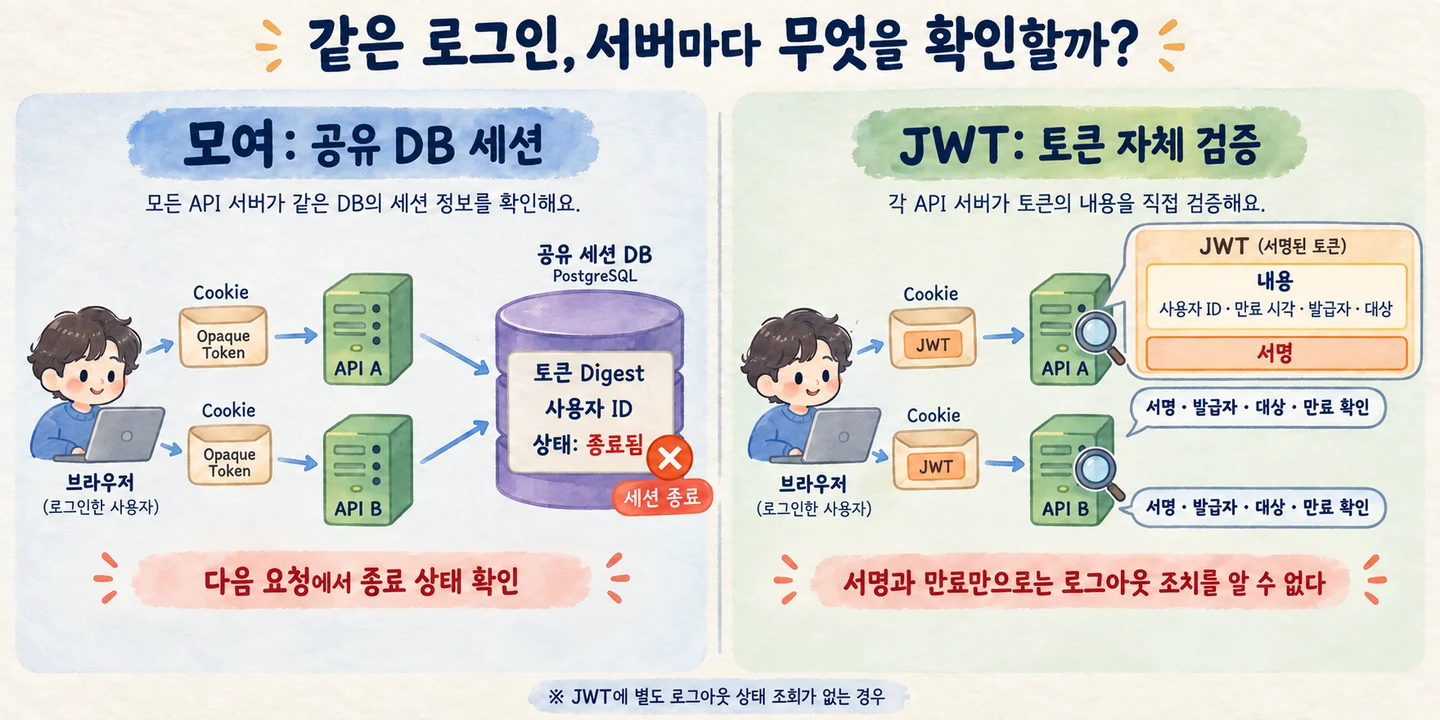
모여에서는 운영자가 로그인을 끝냈을 때 그 조치를 다음 요청부터 반영할 수 있어야 했다. 두 방식은 바로 여기서 갈린다. 아래 움직이는 도식은 같은 로그아웃 조치 이후 두 방식이 다음 요청을 어떻게 처리하는지 보여준다. JWT 쪽은 아직 만료되지 않은 토큰이며, 별도로 로그아웃 상태를 조회하지 않는 경우다.
DB 세션은 거부한다. 로그아웃 상태를 조회하지 않는 JWT는 토큰 검증을 통과한다.
JWT도 로그아웃 상태를 조회할 수 있지만, 저장소 조회 비용이 생긴다전체 과정을 글로 보기
- 요청을 두 API 서버가 나눠 처리한다
DB 세션은 같은 기록을 조회하고, JWT는 각 서버에서 토큰을 검증한다.
- 운영자가 기존 로그인을 끝낸다
공유 DB에는 세션 종료가 기록된다. 이미 발급된 JWT의 내용은 바뀌지 않는다.
- 같은 로그인 정보로 API B에 요청한다
DB 세션은 종료 상태를 읽는다. JWT는 토큰의 서명과 만료 등을 확인한다.
- 다음 요청의 결과가 달라진다
DB 세션은 거부한다. 로그아웃 상태를 조회하지 않는 JWT는 토큰 검증을 통과한다.
공유 DB 세션에서는 어느 API 서버로 요청하더라도 종료된 기록을 보고 거부할 수 있다. 반면 JWT의 서명과 만료만 검사하면 운영자가 방금 한 조치를 알 수 없다. JWT가 틀린 방식이라는 뜻은 아니다. 무엇을 매 요청에 확인할지 선택하면 그에 따른 장점과 비용이 생긴다.
| 방식 | 얻는 것 | 감당할 비용 |
|---|---|---|
| 공유 DB 세션 | 어느 서버에서든 현재 로그인 기록을 확인 | 요청마다 DB를 조회하며, DB 장애에도 대비해야 한다 |
| 세션 조회 없는 JWT | 중앙 저장소를 조회하지 않고 토큰을 검증 | 서명 검증 비용과 전송 크기, 만료 전 로그아웃 반영을 고려해야 한다 |
| Redis 등 공유 세션 저장소 | 메모리 기반으로 세션을 빠르게 조회 | 별도 저장소의 메모리 비용과 장애·데이터 보존 정책을 관리해야 한다 |
모여에서는 로그인 상태를 바꿀 수 있다는 점이 중요했다. 기기 제한, 사용자·운영자의 로그아웃, 비밀번호 변경 뒤 다른 기기 정리를 이미 사용하는 DB에서 처리할 수 있었다. 그래서 공유 DB 세션을 선택했다. 서버 대수가 늘어나도 같은 DB를 보면 되므로, 그것만으로 이 선택을 바꿀 이유는 없다.
더 살펴보기: 서버 간 세션 공유와 JWT의 로그아웃 처리
서버 A가 기억한 로그인을 서버 B도 알아야 한다
세션을 서버 A의 메모리에만 저장하면 서버 B는 그 로그인 기록을 모른다. 서버 A를 재시작하면 기록이 사라질 수도 있다. 따라서 로그인한 서버에 다음 요청도 보내거나, 여러 서버가 같은 저장소를 보도록 해야 한다. 서버 한 대의 메모리를 키우는 것만으로는 이 문제가 해결되지 않는다.
공유 DB를 쓰면 기록을 함께 볼 수 있지만, 조회가 늘어나는 만큼 DB 연결과 검색 비용도 든다. 만료된 세션을 정리하는 작업도 필요하다. 모여가 최근 사용 시각을 최소 15분 간격으로 기록하는 것은 요청마다 DB에 쓰는 작업까지 늘어나는 것을 줄이기 위해서다.
Redis를 추가한다면 메모리에서 빠르게 조회할 수 있는 장점이 있다. 대신 저장소가 멈췄을 때 어떻게 할지, 데이터를 어디까지 보존할지, 동시에 들어온 로그인 수를 어떻게 제한할지도 새로 관리해야 한다.
토큰 갱신을 막아도 이미 발급한 토큰은 남는다
JWT도 강제 로그아웃을 구현할 수 있다. 서버에 차단한 토큰 목록을 두거나, 계정별로 번호를 두고 토큰에 담긴 번호와 비교하는 식이다. 다만 이 상태를 조회하는 비용이 다시 생긴다.
액세스 토큰의 수명을 짧게 하고 리프레시 토큰으로 새 토큰을 받게 할 수도 있다. 액세스 토큰은 API 요청에 사용하고, 리프레시 토큰은 새 액세스 토큰을 발급받는 데 사용한다. 리프레시 토큰을 막으면 다음 갱신은 못 하지만, 이미 발급한 액세스 토큰은 만료까지 남을 수 있다. 다음 요청부터 바로 거부해야 한다면 요청마다 로그아웃 상태를 확인하는 처리가 필요하다.
서명 확인과 정보 암호화는 다르다
JWT를 검증할 때는 서명뿐 아니라 어떤 알고리즘으로 만들었는지, 누가 발급했는지, 어느 서비스에서 쓸 토큰인지, 만료됐는지도 확인해야 한다. 흔히 사용하는 서명 JWT의 내용은 Base64URL로 인코딩됐을 뿐이라 토큰을 가진 누구나 읽을 수 있다. 서명은 위조를 막을 뿐이므로 민감한 정보는 넣지 않아야 한다.
JWT를 사용해도 계정이 제한됐는지, 현재 권한이 바뀌었는지 확인하려면 DB 조회가 필요할 수 있다. 토큰 형식을 바꾼다고 서비스의 모든 상태 조회가 사라지지는 않는다.
JWT 검증과 DB 세션 조회 중 무엇이 더 빠른지는 실제 환경과 부하를 측정해야 판단할 수 있다. 앱이나 외부 프로그램에서 API를 호출할 때도 Opaque Token을 사용할 수 있다. 토큰을 쿠키로 보낼지, 헤더에 직접 넣을지와 토큰을 어떤 형식으로 만들지는 각각 선택할 문제다.
비밀번호를 안전하게 저장하는 데도 비용이 든다
세션은 로그인한 뒤의 이야기다. 그 전에 확인하는 비밀번호는 어떻게 저장해야 할까? 서버가 공격당했을 때 저장된 비밀번호까지 그대로 노출되면 피해가 커진다. 모여는 비밀번호 원문을 저장하지 않고 Argon2id로 만든 해시를 저장한다.
해시는 입력값을 정해진 알고리즘으로 계산해 얻은 값이다. 비밀번호를 확인할 때는 사용자가 입력한 비밀번호를 같은 설정으로 계산해, 저장된 해시와 일치하는지 검증한다. 하지만 빠르게 계산할 수 있는 일반 해시만 사용하면 공격자도 흔한 비밀번호를 빠르게 대입할 수 있다. 비밀번호 저장용 해싱은 추측 한 번에 드는 계산과 메모리 비용을 높인다.
모여는 Bun이 제공하는 Argon2id를 선택했다. 별도의 알고리즘을 직접 구현하지 않고, 다음 설정으로 해시를 만든다.
const passwordHash = await passwordApi.hash(plainTextPassword, {
  algorithm: "argon2id",
  memoryCost: 65_536,
  timeCost: 3,
});tsmemoryCost: 65_536은 64MiB에 해당한다. 공격자가 비밀번호 후보를 계산하는 데 부담을 주지만, 우리 서버도 그 비용을 지불한다. 해시 8개가 실제로 동시에 실행된다면 설정상 메모리 예산은 64MiB × 8 = 512MiB가 된다.
다음 도식은 동시에 실행하는 해시의 개수에 따라 메모리 예산이 늘어나는 모습을 보여준다. 수치는 실제 서버 사용량을 측정한 결과가 아니라, 설정값을 바탕으로 계산한 예산이다.
64MiB × 16 = 1024MiB. 비밀번호를 확인하는 데 드는 메모리 예산이다.
도착한 요청 수가 아니라 실제로 동시에 실행하는 해시 수전체 과정을 글로 보기
- 해시 1개가 동시에 실행된다면
64MiB × 1 = 64MiB. 비밀번호를 확인하는 데 드는 메모리 예산이다.
- 해시 4개가 동시에 실행된다면
64MiB × 4 = 256MiB. 비밀번호를 확인하는 데 드는 메모리 예산이다.
- 해시 8개가 동시에 실행된다면
64MiB × 8 = 512MiB. 비밀번호를 확인하는 데 드는 메모리 예산이다.
- 해시 16개가 동시에 실행된다면
64MiB × 16 = 1024MiB. 비밀번호를 확인하는 데 드는 메모리 예산이다.
그런데 모여의 EC2는 2026년 10월 기준 메모리 4GiB인 작은 인스턴스다. 다른 API와 작업도 같은 서버에서 실행되므로 해싱에만 메모리를 모두 줄 수는 없다. 그래서 비밀번호를 검증하기 전에 로그인 시도 횟수도 제한한다.
모여는 기본적으로 15분 동안 같은 이메일에 대한 로그인 시도를 10회로 제한한다. IP 주소를 일부 범위로 묶은 IP prefix를 확인할 수 있다면, 같은 범위의 시도를 50회로 제한하는 조건도 적용한다. 비밀번호가 맞았는지와 관계없이 로그인 시도 자체를 센다.
보안에 도움이 되는 비용이라도 서비스가 감당할 수 있는지 봐야 한다. 매번 설정을 크게 올리는 것보다 해싱 비용, 동시 실행 수, 요청 제한을 함께 고민하는 편이 현실적이었다. 다행히 이 비용은 로그인할 때만 든다. 앞에서 본 것처럼 다음 요청부터는 Argon2id를 다시 실행하지 않고 세션을 조회한다.
더 살펴보기: 다른 해싱 방식과 OWASP의 도움
알고리즘 이름만으로 선택하지 않는다
Argon2id 외에도 비밀번호 저장에 사용하는 방식은 여러 가지다. 이미 운영 중인 시스템인지, 런타임이 무엇을 지원하는지, 따라야 하는 규정이 있는지에 따라 선택이 달라질 수 있다.
| 방식 | 고려할 상황 | 확인할 점 |
|---|---|---|
| Argon2id | 새로운 비밀번호 저장 구현 | 메모리·계산 비용과 런타임 지원 |
| scrypt | Argon2id를 사용할 수 없는 환경 | 파라미터 조합과 메모리 예산 |
| bcrypt | 기존 시스템과의 호환성을 유지할 때 | 계산 비용과 긴 비밀번호 처리 방식, 72바이트 입력 제약 |
| PBKDF2 | FIPS 같은 규정 요건이 있는 환경 | 요구하는 암호 모듈과 구현, 반복 횟수 |
해시 하나의 비용과 동시 실행 비용을 구분한다
Bun이 만든 해시 문자열에는 salt와 계산 설정도 함께 들어 있다. salt는 같은 비밀번호라도 서로 다른 해시가 나오게 하기 위해 더하는 무작위 값이다. 비밀번호를 검증할 때는 저장된 문자열에 포함된 값과 설정을 사용한다.
모여의 코드에서는 병렬성 옵션을 직접 지정하지 않는다. timeCost: 3은 계산 비용에 관한 설정이며, 메모리 64MiB를 세 배로 사용한다는 뜻은 아니다.
앞의 도식은 해시가 동시에 몇 개 실행되는지에 따른 계산이다. 요청 16개가 들어와도 일부가 기다리고 있다면 동시에 실행되는 해시는 그보다 적다. 16칸은 모여의 실제 실행 한도를 뜻하지도 않는다. 서버 프로그램이 사용하는 다른 메모리까지 합친 실제 사용량과 응답 시간은 따로 측정해야 한다.
요청 제한도 어디에서 세는지 확인한다
모여는 인증 시도 횟수를 PostgreSQL에 저장한다. 두 요청이 동시에 들어와도 서로의 증가분을 덮어쓰지 않도록 갱신하므로, 여러 API 서버가 같은 DB의 횟수를 함께 사용할 수 있다.
반면 일반 HTTP 요청에 사용하는 Fastify rate limit은 현재 서버 프로세스마다 따로 센다. 서버를 여러 대로 늘리면 같은 사람이 서버마다 허용된 횟수만큼 요청할 수 있다. 그래서 설정에 적힌 숫자와 함께 어디까지 합쳐 세는지도 확인한다.
OWASP는 빠뜨린 조건을 점검하는 데 도움이 됐다
직접 구현하다 보면 “비밀번호를 해시했으니 됐다”고 생각하고 다음으로 넘어가기 쉽다. OWASP의 자료는 세션 만료나 CSRF 방어, 해싱 설정처럼 함께 확인할 조건을 찾는 데 도움이 됐다.
Cheat Sheet는 “이 문제를 구현할 때 무엇을 챙길까?”에 가까운 안내이고, ASVS는 “구현한 서비스가 어떤 보안 요구사항을 충족해야 할까?”를 점검하는 기준이다. 특정 해싱 알고리즘이나 설치만 하면 되는 라이브러리가 아니라, 설계와 검증에 참고하는 자료다. 인증 정책은 NIST 자료를, 알고리즘의 정확한 동작은 해당 명세를 함께 확인하는 식으로 목적에 맞게 참고할 수 있다.
응답 시간으로 가입 여부를 추측하는 것도 줄인다
가입된 이메일에는 느린 비밀번호 검증을 하고, 없는 이메일에는 바로 응답한다면 걸린 시간으로 가입 여부를 추측할 수 있다. 그래서 없는 이메일에도 검증용으로 준비한 더미 해시를 사용해 비밀번호 검증을 수행한다. 시간 차이를 줄이기 위한 처리다. 다만 소셜 로그인 전용 계정에는 별도 응답이 있으므로, 가입 여부가 드러나는 문제를 완전히 해결했다고 말할 수는 없다.
비밀번호를 확인한 뒤 세션을 저장하기 전까지 다른 요청이 비밀번호를 바꿀 수도 있다. 모여는 세션을 만들 때 비밀번호 버전을 다시 확인해, 방금 확인한 비밀번호가 여전히 현재 비밀번호인지 검사한다.
로그인 코드 밖에서도 지켜야 할 것들
인증 코드를 잘 만들어도 DB를 인터넷에 열어 두거나, 사용자 요청과 운영 접속을 구분하지 않으면 보호해야 할 범위가 커진다. 모여에서는 요청이 서버와 DB에 도달하는 경로도 함께 살펴봤다.
API는 앞에서 말한 Cloudflare Tunnel로 EC2에 연결한다. EC2 쪽에서 Cloudflare로 연결을 만들고, 그 연결을 통해 API 요청이 들어온다. 그래서 앱 보안 그룹에는 인바운드 허용 규칙을 두지 않았다. 인터넷에서 EC2의 API 포트나 SSH 포트로 바로 들어오는 길이 없으니, 운영자가 서버를 관리할 때는 AWS의 관리 서비스인 SSM으로 접속한다.
DB는 공개 접근을 끈 RDS다. PostgreSQL 포트는 앱 보안 그룹에서만 접근하게 했다. 아래 도식은 사용자 요청이 들어오는 경로와 DB에 접근할 수 있는 범위를 보여준다.
접근 경로를 제한했더라도, 그 경로로 들어온 요청이 누구의 것인지는 따로 확인해야 한다. 그래서 NestJS는 전달받은 요청마다 세션과 작업 권한을 검사한다.
API에는 Helmet을 적용해 CSP 등 보안 헤더를 설정했고, EC2와 RDS의 저장소도 암호화했다. Cloudflare에서는 HTTPS 전환과 TLS 설정, 기본 DDoS 보호를 확인했다. 다만 Cloudflare를 쓴다고 모든 보안 기능이 켜져 있다고 생각하지는 않았다. 실제로 적용한 설정을 확인하는 것도 구현의 일부였다.
운영 설정 더 보기: 무엇을 보호하고, 어디까지 적용했을까?
서버 밖의 보안은 통신, 저장, 접근 경로로 나눠 점검했다.
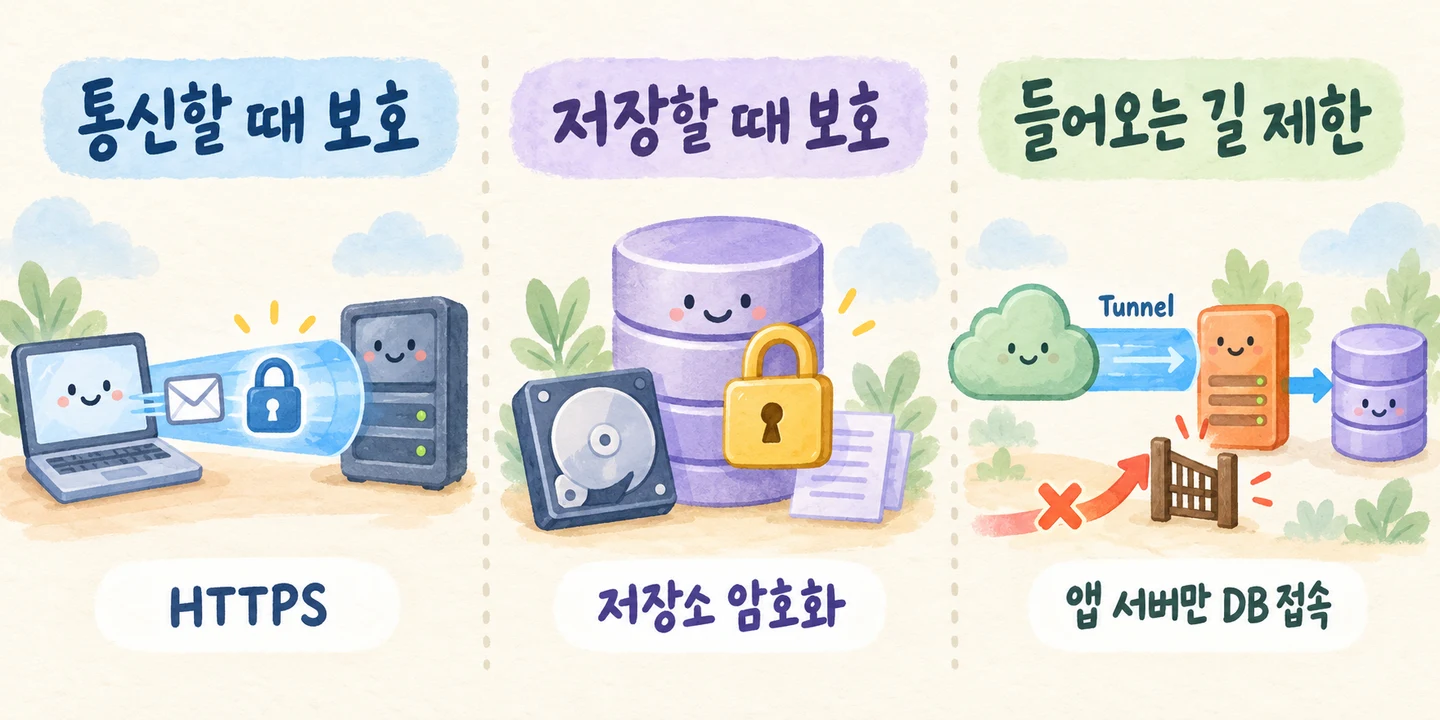
통신할 때는 내용을 엿보기 어렵게 한다
브라우저와 서버가 정보를 주고받을 때는 HTTPS를 사용한다. Cloudflare에서 HTTP 요청을 HTTPS로 돌리고, 암호화 통신에 TLS 1.2 이상을 사용하도록 설정했다. API는 브라우저가 이후에도 HTTPS를 쓰도록 알리는 HSTS 헤더도 보낸다.
설정이 적용된 위치는 구분했다. API가 HSTS를 보내고 있어도 Cloudflare 자체의 HSTS 설정은 꺼져 있었다. 웹 페이지와 API의 보안 헤더도 같지 않았다. 어느 응답에 어떤 설정이 적용됐는지 각각 확인했다.
저장할 때도 암호화한다
서버의 디스크인 EBS와 데이터베이스인 RDS의 저장소를 암호화했다. 앞의 HTTPS가 이동 중인 정보를 보호한다면, 이 설정은 서버에 저장된 정보를 보호하기 위한 것이다.
EC2가 자신의 설정과 정보를 조회할 때도 접근 토큰을 요구하도록 했다. 이를 위해 IMDSv2를 사용한다. 조회 주소를 안다고 아무 요청으로나 서버 정보를 읽게 두지 않으려는 조치다.
서버와 DB에 들어오는 길을 줄인다
본문에서 본 Tunnel과 보안 그룹 설정이 여기에 해당한다. 인터넷에서 EC2로 바로 접속하는 길은 닫고, DB에는 앱 서버만 연결할 수 있게 했다. 로그인 코드가 요청의 사용자를 확인한다면, 이 설정은 그 요청이 들어오는 경로를 제한한다.
다만 장애 대비는 별도로 준비해야 한다. 글을 쓰는 2026년 10월에는 EC2 한 대와 단일 AZ RDS를 쓰고 있다. AZ는 AWS가 데이터센터를 나눠 운영하는 구역이다. 서버나 해당 구역에 문제가 생기면 서비스가 중단될 수 있다. 암호화는 데이터를 지키는 설정이고, 장애 대비는 따로 풀어야 할 문제다.
Cloudflare의 추가 기능도 실제로 적용한 범위만 적었다. Access로 접근을 제한하는 곳은 개발 환경이다. 운영 관리자 화면은 별도로 봐야 한다. 봇 요청을 막는 Bot Fight Mode는 꺼져 있고, 흔한 웹 공격을 검사하는 OWASP Core Ruleset은 실제 적용 여부를 확인하지 못했다.
접속 위치는 참고 정보로 사용한다. 신뢰하도록 설정한 중계 경로에서 받은 위치 헤더만 읽고 검증한다. 여행이나 VPN 때문에 접속 나라가 바뀔 수 있으므로, 나라가 달라졌다는 이유만으로 공격이라고 판단하지 않는다. 위치를 알 수 없다면 모르는 상태로 남긴다.
마치며
모여를 혼자 기획하고, 디자인하고, 개발하면서 정말 많은 것을 배웠다. 혼자 만드는 가장 큰 장점은 내가 원하는 방식과 속도로 구현할 수 있다는 점이었다. 궁금한 문제를 깊이 파고들고, 내가 내린 선택의 결과도 직접 확인할 수 있었다.
AI 시대에는 개발을 잘 몰라도 제품을 만들고, 제품이 시장에 맞는지(PMF) 확인해 볼 수 있다고 생각한다. 도메인을 깊이 아는 사람이 개발자도 떠올리지 못한 서비스를 만들 수 있고, 아무리 좋은 코드로 만들었어도 쓰이지 않는다면 제품으로서의 의미는 작다. 그 사실은 나도 잘 알고 있다.
다만 비개발자가 만든 여러 서비스를 써 보면서, 좋은 아이디어와 별개로 아쉬운 부분도 경험했다. 누군가에게는 사소한 버그일 수 있지만, 서비스를 만드는 입장에서는 자꾸 눈에 들어오는 작은 불편들이 있었다. 그렇다면 개발자인 나는 어디에서 차이를 만들 수 있을까? 내가 찾은 답은 사용자가 믿고 쓸 수 있는 서비스를 만드는 일이었다.
그 신뢰를 말로만 약속하고 싶지는 않았다. 예상하지 못한 상황에서도 동작을 일관되게 유지하고, 사용자의 계정과 정보를 보호하도록 코드와 보안을 더 챙기고 싶었다. 그렇다고 당장 필요 없는 구조까지 미리 만들지는 않았다. 지금 필요한 문제를, 현재의 시간과 비용 안에서 내가 아는 가장 합리적인 방법으로 해결하려는 것이다.
정답은 없다고 생각한다. 어떤 선택이 맞았는지는 서비스를 운영하며 확인하려 한다. 사용자가 늘면 사용 패턴과 부하를 보며 기기 제한과 인증 조회 비용, 해싱 설정도 다시 살펴볼 생각이다. 지금의 설계를 고집하기보다, 사용자 경험과 운영에 필요한 통제를 기준으로 판단하고 싶다.
내가 부족해서 놓친 문제와, 알고도 외면한 문제는 모두 사용자의 신뢰를 잃게 할 수 있다. 사용자에게는 같은 실망일 수 있지만, 만드는 사람의 태도까지 같지는 않다고 생각한다. 모르는 것은 배우고, 아는 문제는 외면하지 않으면서 더 나은 선택을 코드로 만들어 가고 싶다.
어쩌면 이것이 내가 개발을 좋아했던 이유이면서, 꾸준히 서비스를 만들며 공부를 해 온 이유이지 않을까?
같이 읽으면 도움이 되는 글
이 글에서 짧게 넘어간 개념은 아래 글에서 더 자세히 다뤘다.
- HTTP 쿠키 이해하기: 브라우저가 쿠키를 저장하고 다음 요청에 보내는 과정.
- 동일 출처 정책 쉽게 이해하기: 브라우저가 두 주소를 같은 출처로 판단하는 기준.
- CORS 쉽게 이해하기: 다른 출처의 API를 호출할 때 브라우저와 서버가 확인하는 조건.
- 세션 하이재킹과 HttpOnly: 세션 탈취가 일어나는 방식과 쿠키 보호의 역할.
- XSS 공격이란?: 악성 스크립트가 사용자의 브라우저에서 실행되는 문제.
- CSRF 공격과 방어법: 로그인한 브라우저가 의도하지 않은 요청을 보내는 문제.
- CSP로 배우는 웹 보안 설정법: 브라우저가 불러오고 실행할 콘텐츠의 범위를 제한하는 방법.